SpecDec-Context-Scaling 项目解读:8GB GPU 上投机解码为什么没有加速
本文是对开源项目 SpecDec-Context-Scaling 的中文技术复盘。项目没有停留在“实现一个投机解码 Demo”,而是追问了一个更接近真实部署的问题:在只有 8 GB 显存的消费级 GPU 上,随着上下文从 2K 增长到 8K,投机解码到底什么时候能够比普通自回归解码更快?
实验给出的答案并不讨巧:在冻结的 Qwen2.5-1.5B / 0.5B 配置下,标准投机解码在所有可比任务族上都更慢。但这个负结果并不是项目的终点。通过接受率诊断、全接受 oracle、bonus token、CUDA Graph 和移除草稿模型等一系列受控实验,项目把失败定位到了一个很具体的系统瓶颈:独立 0.5B 草稿模型的前向成本,超过了减少目标模型调用所节省的时间。
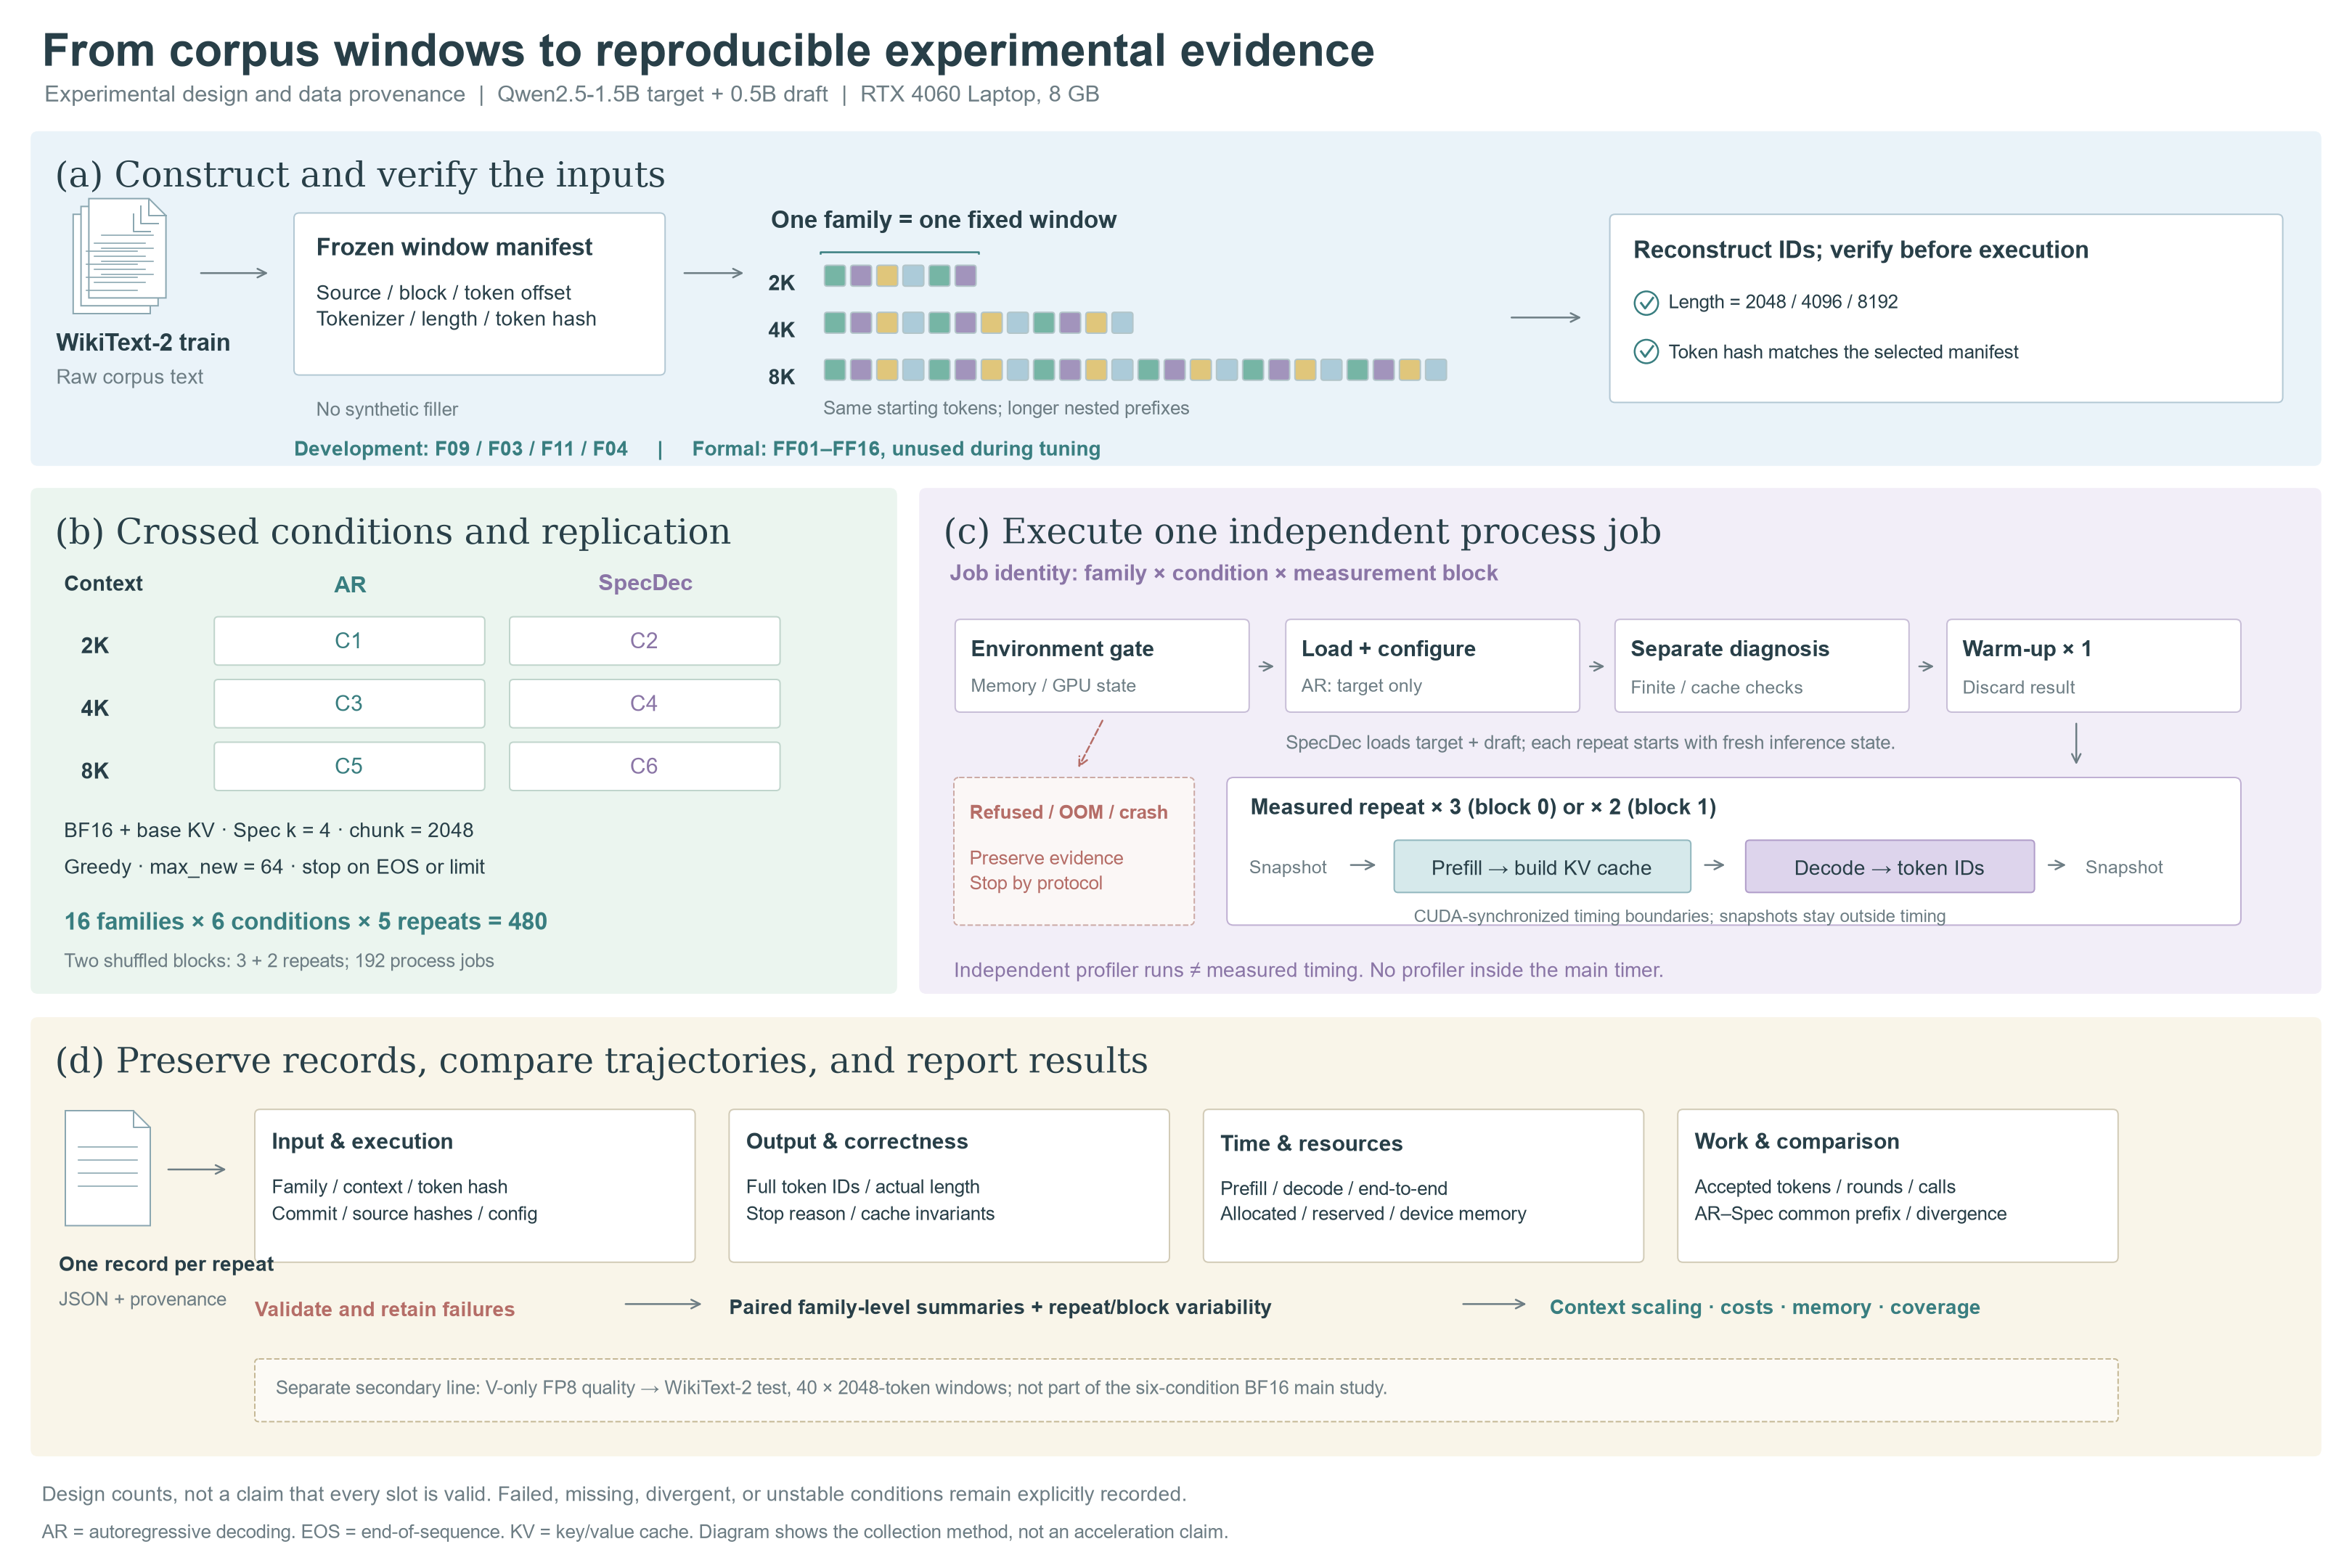
1. 项目要回答什么问题
大语言模型按照自回归方式生成文本。给定已经生成的 token 序列 ,目标模型每次只产生下一个 token:
即使 KV Cache 避免了重复计算历史 token,生成 64 个新 token 仍然需要约 64 次目标模型调用。投机解码的思路是先让更小的草稿模型一次提出多个候选,再让目标模型并行验证,从而用较少的目标模型调用推进多个 token。
但“目标模型调用次数减少”不等于“端到端时间减少”。每一轮投机解码还要支付:
- 草稿模型逐 token 生成候选的成本;
- 目标模型块验证的成本;
- 接受判定、同步与 token 搬运成本;
- 拒绝候选后的 KV Cache 回滚和修复成本;
- 同时保存两个模型权重与两份 KV Cache 的显存成本。
因此,本项目冻结模型、硬件与生成配置,只研究两个核心问题:
- 在 2K、4K、8K 上下文下,标准投机解码是否产生端到端加速?
- 如果没有加速,决定性能上限的是接受率、控制流、CUDA 启动开销,还是草稿模型本身?
这使项目从“算法实现”变成了一个小型的 LLM inference performance study。
2. 技术栈与系统边界
2.1 硬件与模型
| 项目 | 冻结配置 |
|---|---|
| GPU | NVIDIA RTX 4060 Laptop,8 GB VRAM |
| 目标模型 | Qwen2.5-1.5B-Instruct |
| 草稿模型 | Qwen2.5-0.5B-Instruct |
| 计算精度 | BF16 |
| 目标模型 KV | 基础精度 KV;旧配置标签写作 fp16,实际执行为 BF16 |
| 上下文长度 | 2K / 4K / 8K |
| 每次生成 | 最多 64 个 token |
| 推测长度 | |
| 解码 | greedy,batch size = 1 |
| Prefill | chunked prefill,chunk size = 2048 |
2.2 软件栈
项目没有直接调用 vLLM 的现成投机解码接口,而是用 PyTorch 和 Hugging Face 权重搭建最小推理引擎,主要模块包括:
| 模块 | 作用 |
|---|---|
| PyTorch tensors | 模型计算、KV Cache 与计时实验 |
| Hugging Face tokenizer / weights | 复用 Qwen2.5 模型资产 |
| 自建 model forward | 控制 prefill、decode 与 block verification |
| 独立 KV Cache API | 维护 target/draft 两套缓存,并支持 trim 与 repair |
| SpecDec engine | 候选生成、最长前缀验证、拒绝修复与 bonus token |
| CUDA Event / 同步计时 | 记录 GPU 路径的端到端延迟 |
| Bootstrap analysis | 对 family-level 几何均值和区间进行统计汇总 |
| cuDNN fused path | 仅用于 prefill 的局部优化路径 |
这个实现边界很重要。结果描述的是一个明确的单 GPU、单请求、batch 1 系统,不应直接外推到服务器 GPU、高并发调度或其他模型组合。
3. 投机解码在引擎里怎样运行
设当前已提交长度为 ,草稿模型提出 个 token:
目标模型把这 个 token 作为一个 block 做一次前向计算,并找出与目标 greedy 选择相同的最长前缀。若前 个候选通过、第 个失败,则本轮:
- 提交 ;
- 提交目标模型在失败位置给出的 replacement token;
- 将 target 和 draft 的 KV Cache 都修复到长度 ;
- 开始下一轮。
如果 个候选全部通过,标准实现至少可以提交这 个 token;bonus-aware 版本还可以复用最后一个验证位置的 logits,再提交一个目标 token。
3.1 一个容易写错的 logits 对齐
块验证得到的第 行 logits 预测的是候选 之后的下一个 token。因此:
- 验证 要使用进入本轮前保存的
saved_next; rows[0]验证 ;rows[k-2]验证 ;rows[k-1]不验证任何当前候选,只能在全部接受时作为下一 token 的 logits。
这是因果模型中的典型 off-by-one 风险。若直接用 rows[0] 验证 ,程序可能仍能运行,却已经不再是正确的投机解码。
3.2 KV Cache 的提交不变量
项目给每套 cache 定义了相同的不变量:
1 | cache length == 已经提交、可作为后续条件的 token 数 |
若接受前缀长度为 ,在加入 replacement 前必须先将两份 cache 裁剪到 ,再分别用 replacement token 前向一步,使二者都到达 。任何被拒绝的草稿 token 都不能留在 cache 中。
这部分看起来只是工程细节,实际上决定了后续所有 logits 是否仍以同一序列为条件。
4. 确认性实验如何设计
项目正式实验包含:
- 16 个 held-out prompt families;
- 3 个上下文长度;
- AR 与 SpecDec 两种路径;
- 每个单元 5 次重复;
- 共 192 个独立 process jobs、480 次计量运行;
- 正式运行前 warmup,warmup 结果不计入统计;
- 使用 AB/BA 顺序块,降低热状态与执行顺序偏差。
核心指标不是单独比较两个平均延迟,而是对每个任务族计算配对比值:
解释如下:
- :投机解码更快;
- :两者持平;
- :投机解码更慢。
聚合时采用 family-level 几何均值:
并通过 bootstrap 给出置信区间。按 family 配对比把 prompt 难度控制在比较内部,比把所有运行混成两个总均值更可靠。
5. 正式结果:所有上下文长度都没有加速
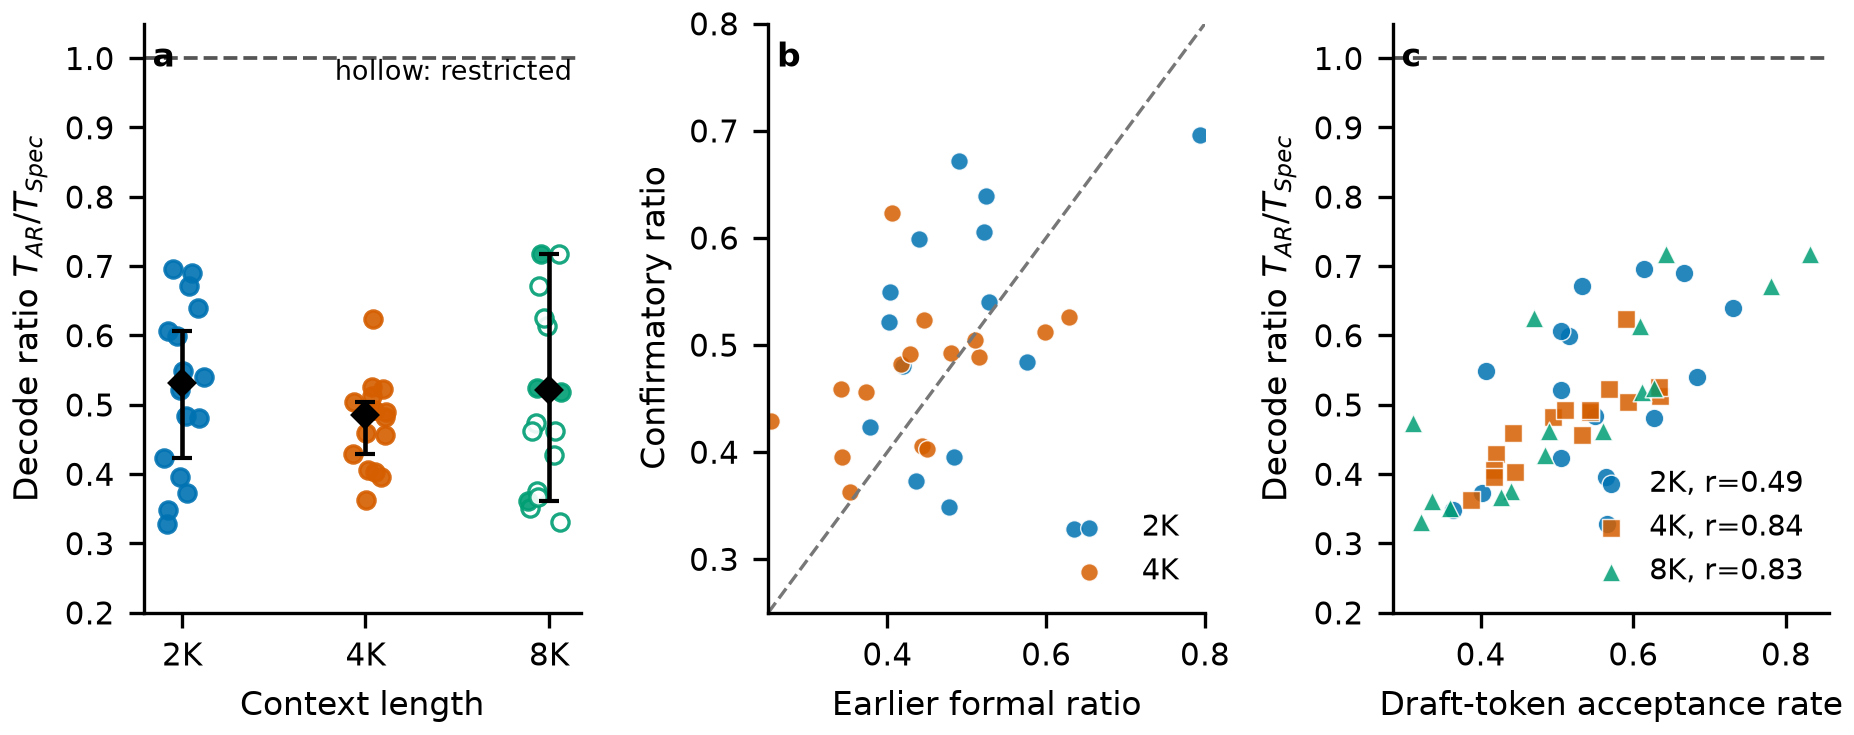
| 上下文 | AR 中位延迟 | SpecDec 中位延迟 | 几何均值 | Bootstrap CI | 推断范围 |
|---|---|---|---|---|---|
| 2K | 2.591 s | 4.772 s | 0.531 | [0.424, 0.606] | 16 families |
| 4K | 2.113 s | 4.646 s | 0.485 | [0.429, 0.504] | 16 families |
| 8K | 2.157 s | 4.732 s | 0.522 | [0.360, 0.717] | 4 families |
2K 和 4K 的 大约只有 0.5,意味着 SpecDec 的延迟约为 AR 的两倍。16 个 family 在每个上下文长度上都没有观察到稳定加速。
8K 需要单独说明:16 个 family 都能得到描述性结果,并且仍全部更慢;但其中 12 个没有通过预先设定的六项计时质量检查,因此 8K 的正式推断只保留 4 个 family。这里不能把 “4” 隐去,也不能把较宽的区间解释成“可能已经加速”。更准确的表述是:现有有效样本没有支持 8K 加速,但推断精度明显低于 2K 和 4K。
6. 为什么目标模型调用减少,时间反而增加
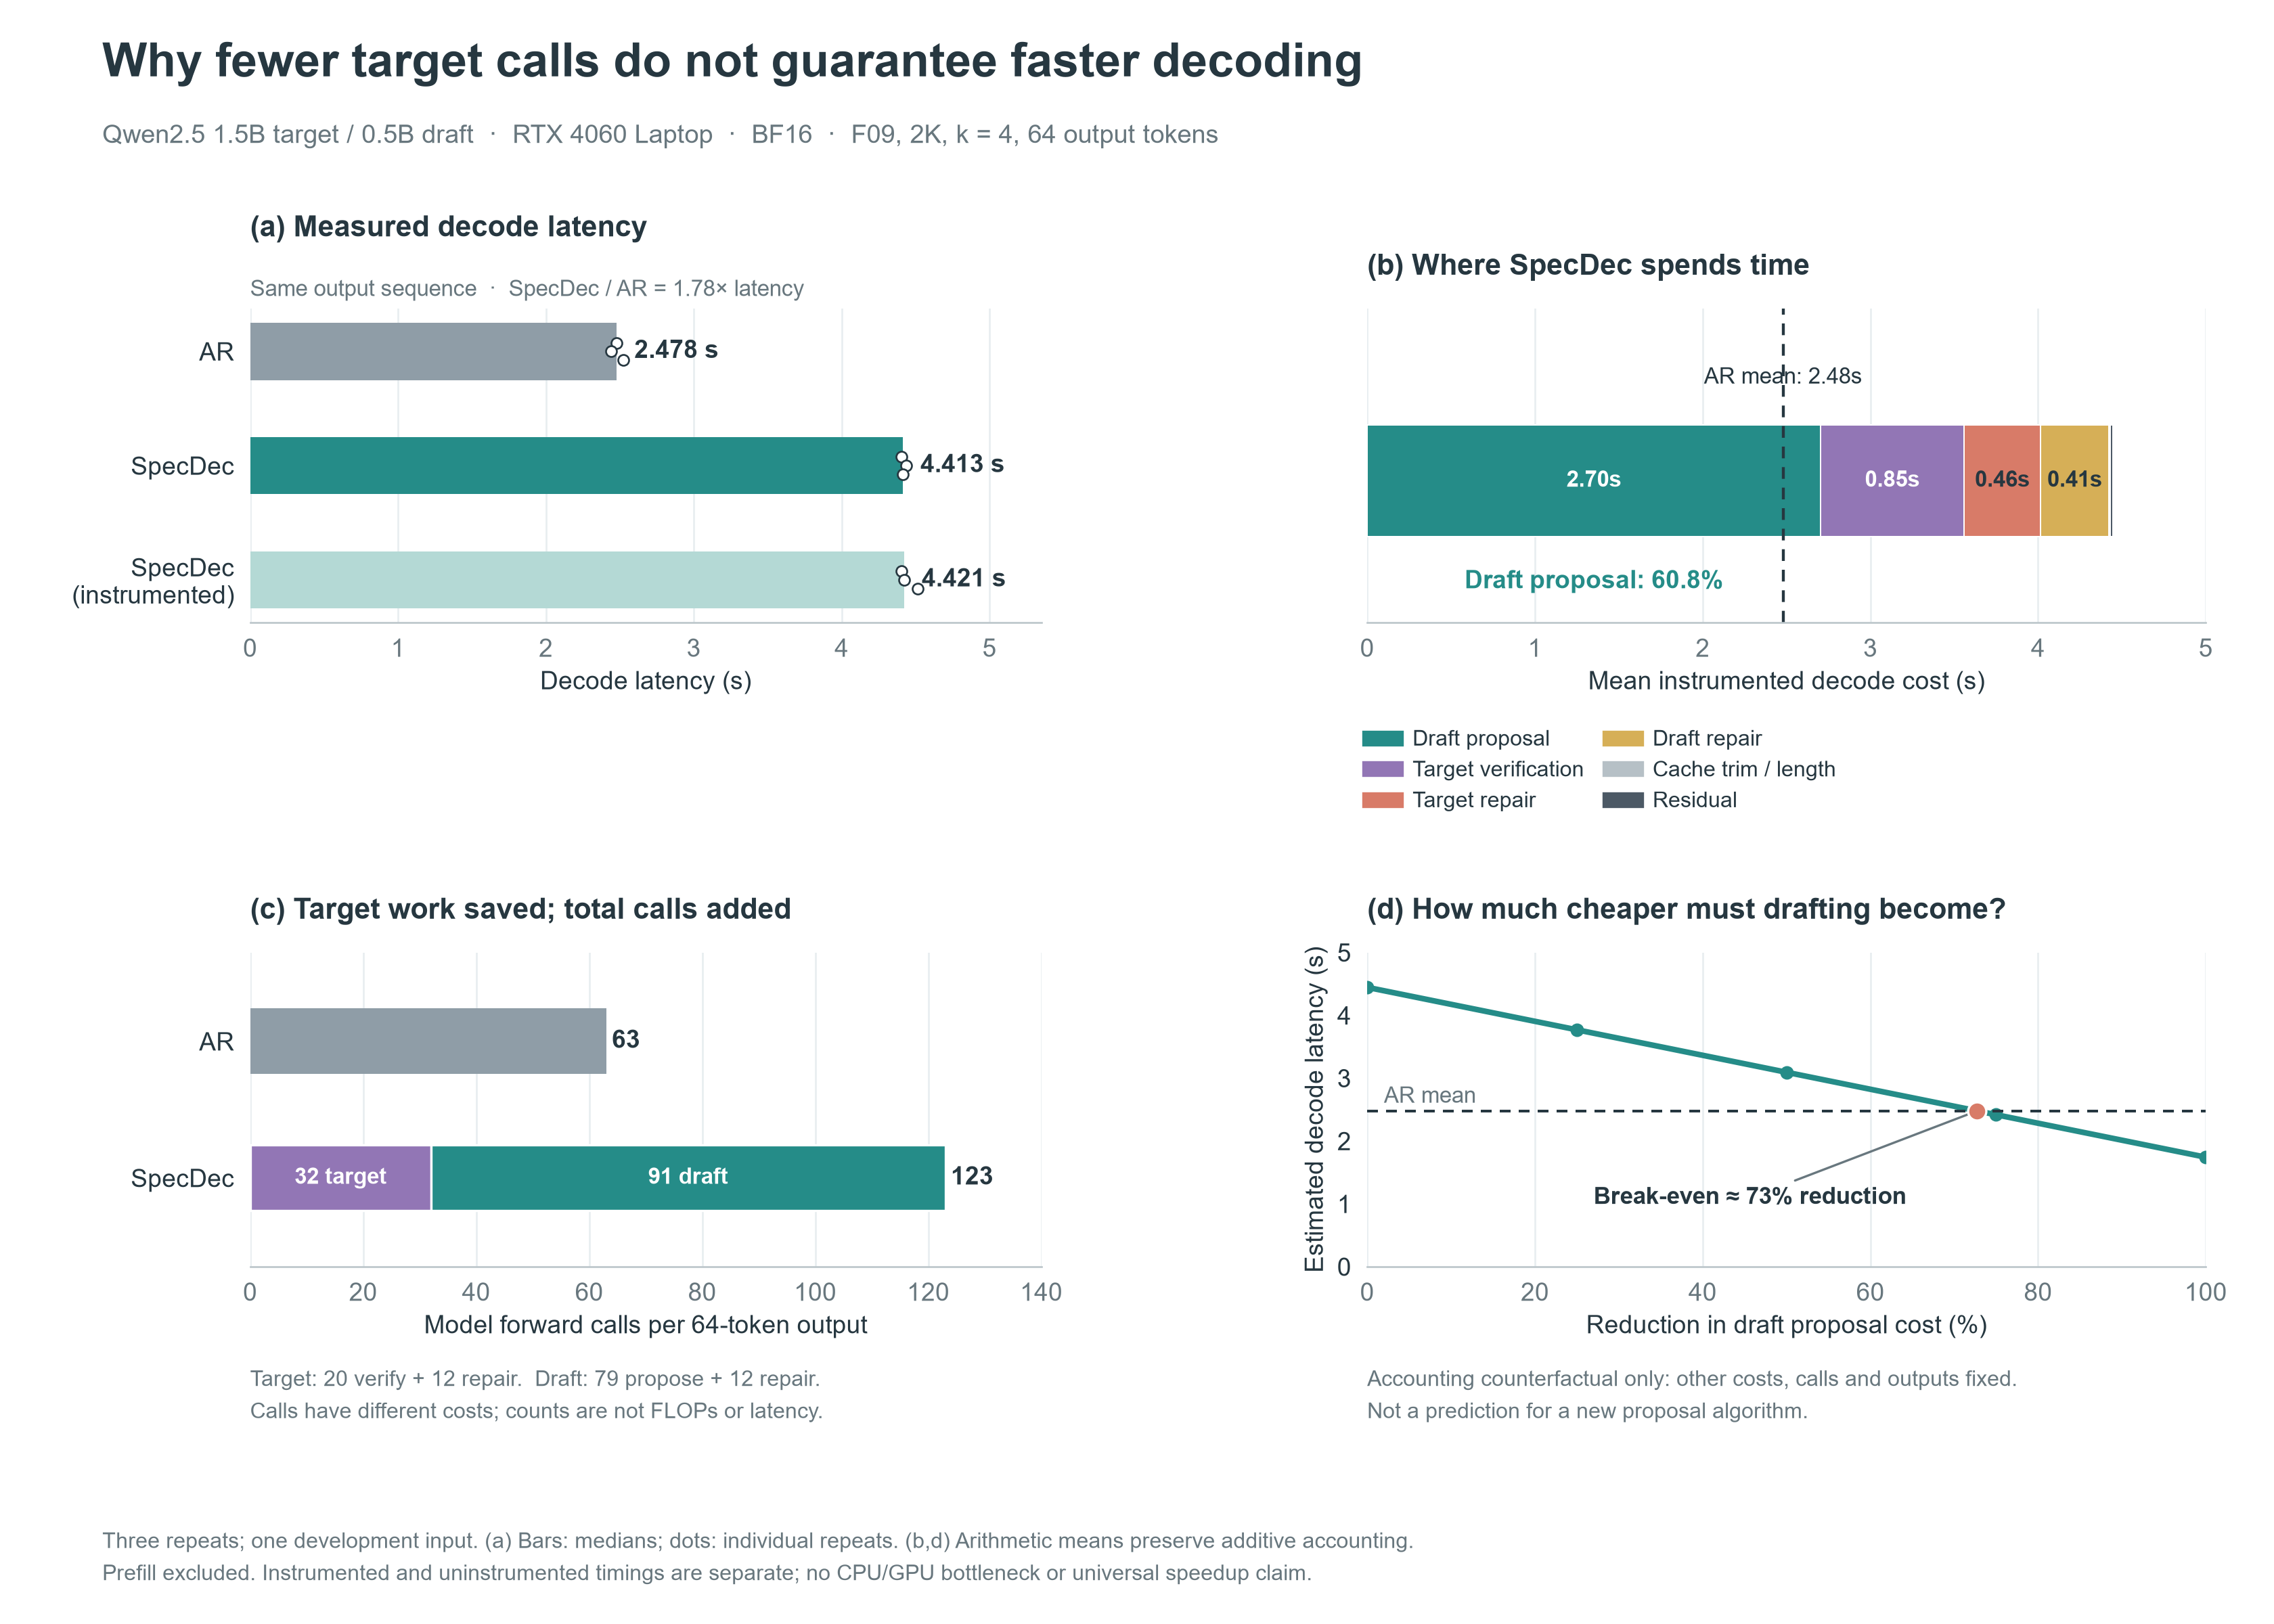
投机解码确实减少了目标模型串行调用,但新增的草稿路径并不便宜。典型任务中,草稿 proposal 占据投机解码总时间的大头。项目的成本图展示了一个代表性例子:AR 约 2.478 秒,而 SpecDec 约 4.413 秒;草稿生成约占 SpecDec 时间的 60.8%。
这个现象可以写成一个简单的每轮成本模型:
其中 是草稿模型单步成本, 是目标模型验证 个候选的成本。若一轮平均提交 个 token,则平均每 token 成本为:
只有当它小于 AR 单 token 成本 时,端到端加速才成立。接受率只影响分母 和 repair 概率,却不能消除 。
正式实验中,三个上下文长度的接受率中位数大约为 0.54、0.52、0.49;每个任务通常仍需 23 到 25 轮、约 39 到 41 次目标调用。接受率不算崩溃,但不足以摊薄独立 0.5B 模型的前向成本。
7. 从“失败”到定位根因:五组机制实验
7.1 Phase O:先清理控制面开销
项目先减少 host-device 同步与 token 搬运:
- 每轮同步次数从 8 次降到 2 次;
- host-to-device token 传输降为 0;
- 端到端延迟下降约 3.8% 到 4.5%。
这证明控制面确实有优化空间,但优化后仍明显慢于 AR。同步并非主要矛盾。
7.2 接受率诊断:模型经常只是“差一点”
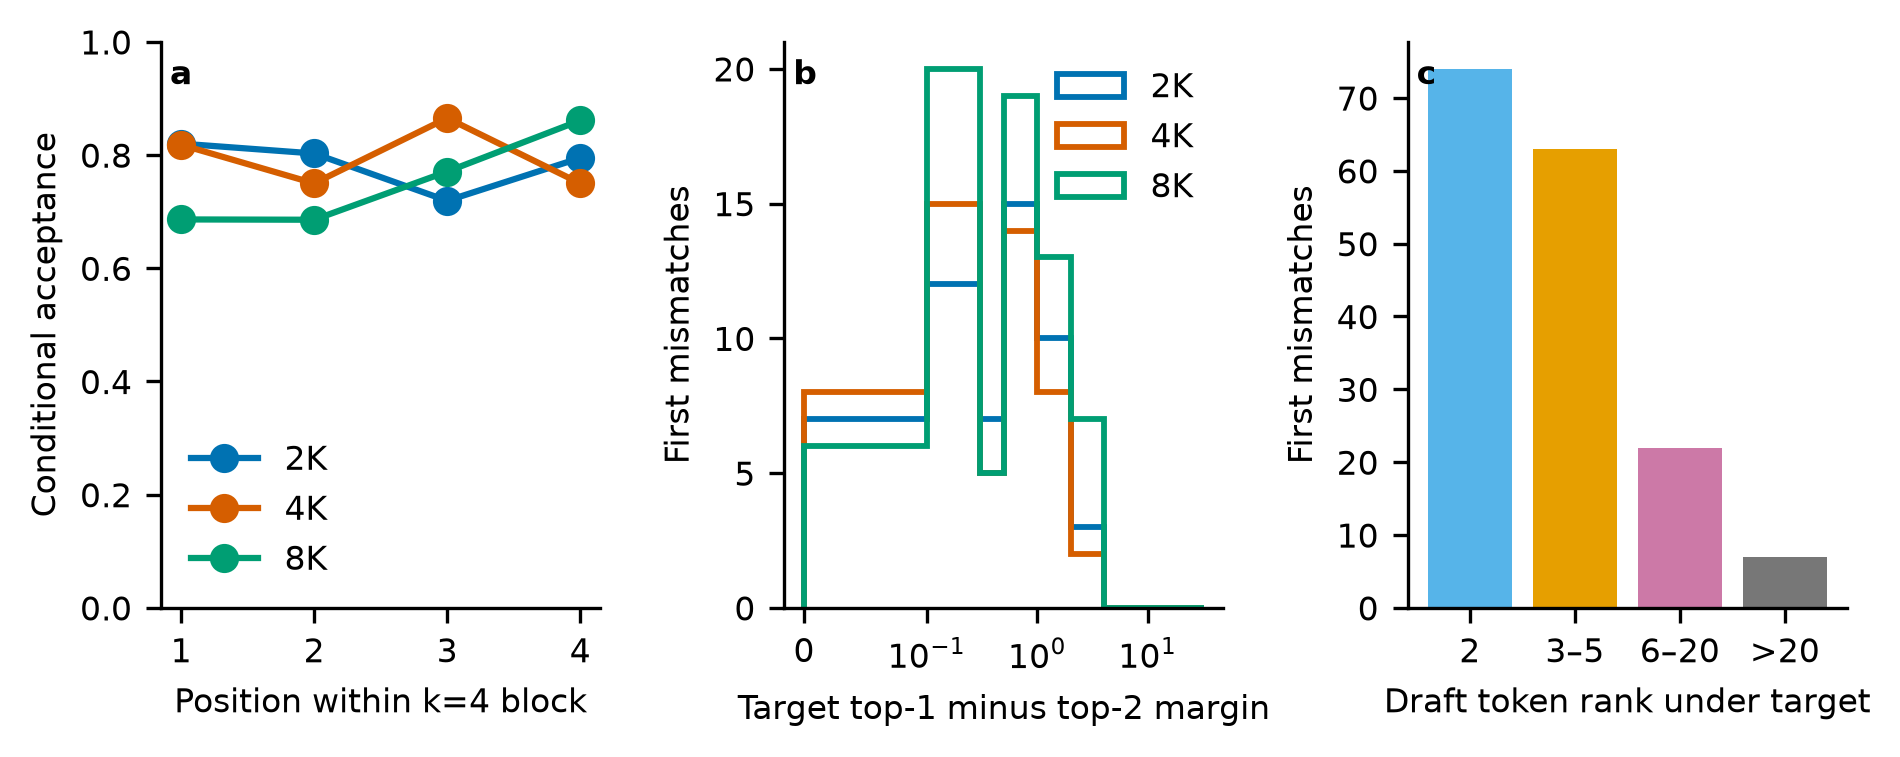
诊断数据发现:草稿 token 在目标分布中的 rank 有 83.5% 不超过 5,57.4% 的位置与目标 top-1 的 logit gap 不超过 1。也就是说,草稿模型经常提出语义上合理、概率也很高的 token,只是没有取得目标模型的第一名。
项目因此尝试 -logit relaxed acceptance:只要候选与目标 top-1 的 logit 差不超过阈值就接受。接受率可提升到约 0.81、0.85、0.75,但此时输出不再保证与目标模型完全一致,而且速度比仍只有 0.714、0.680、0.560。
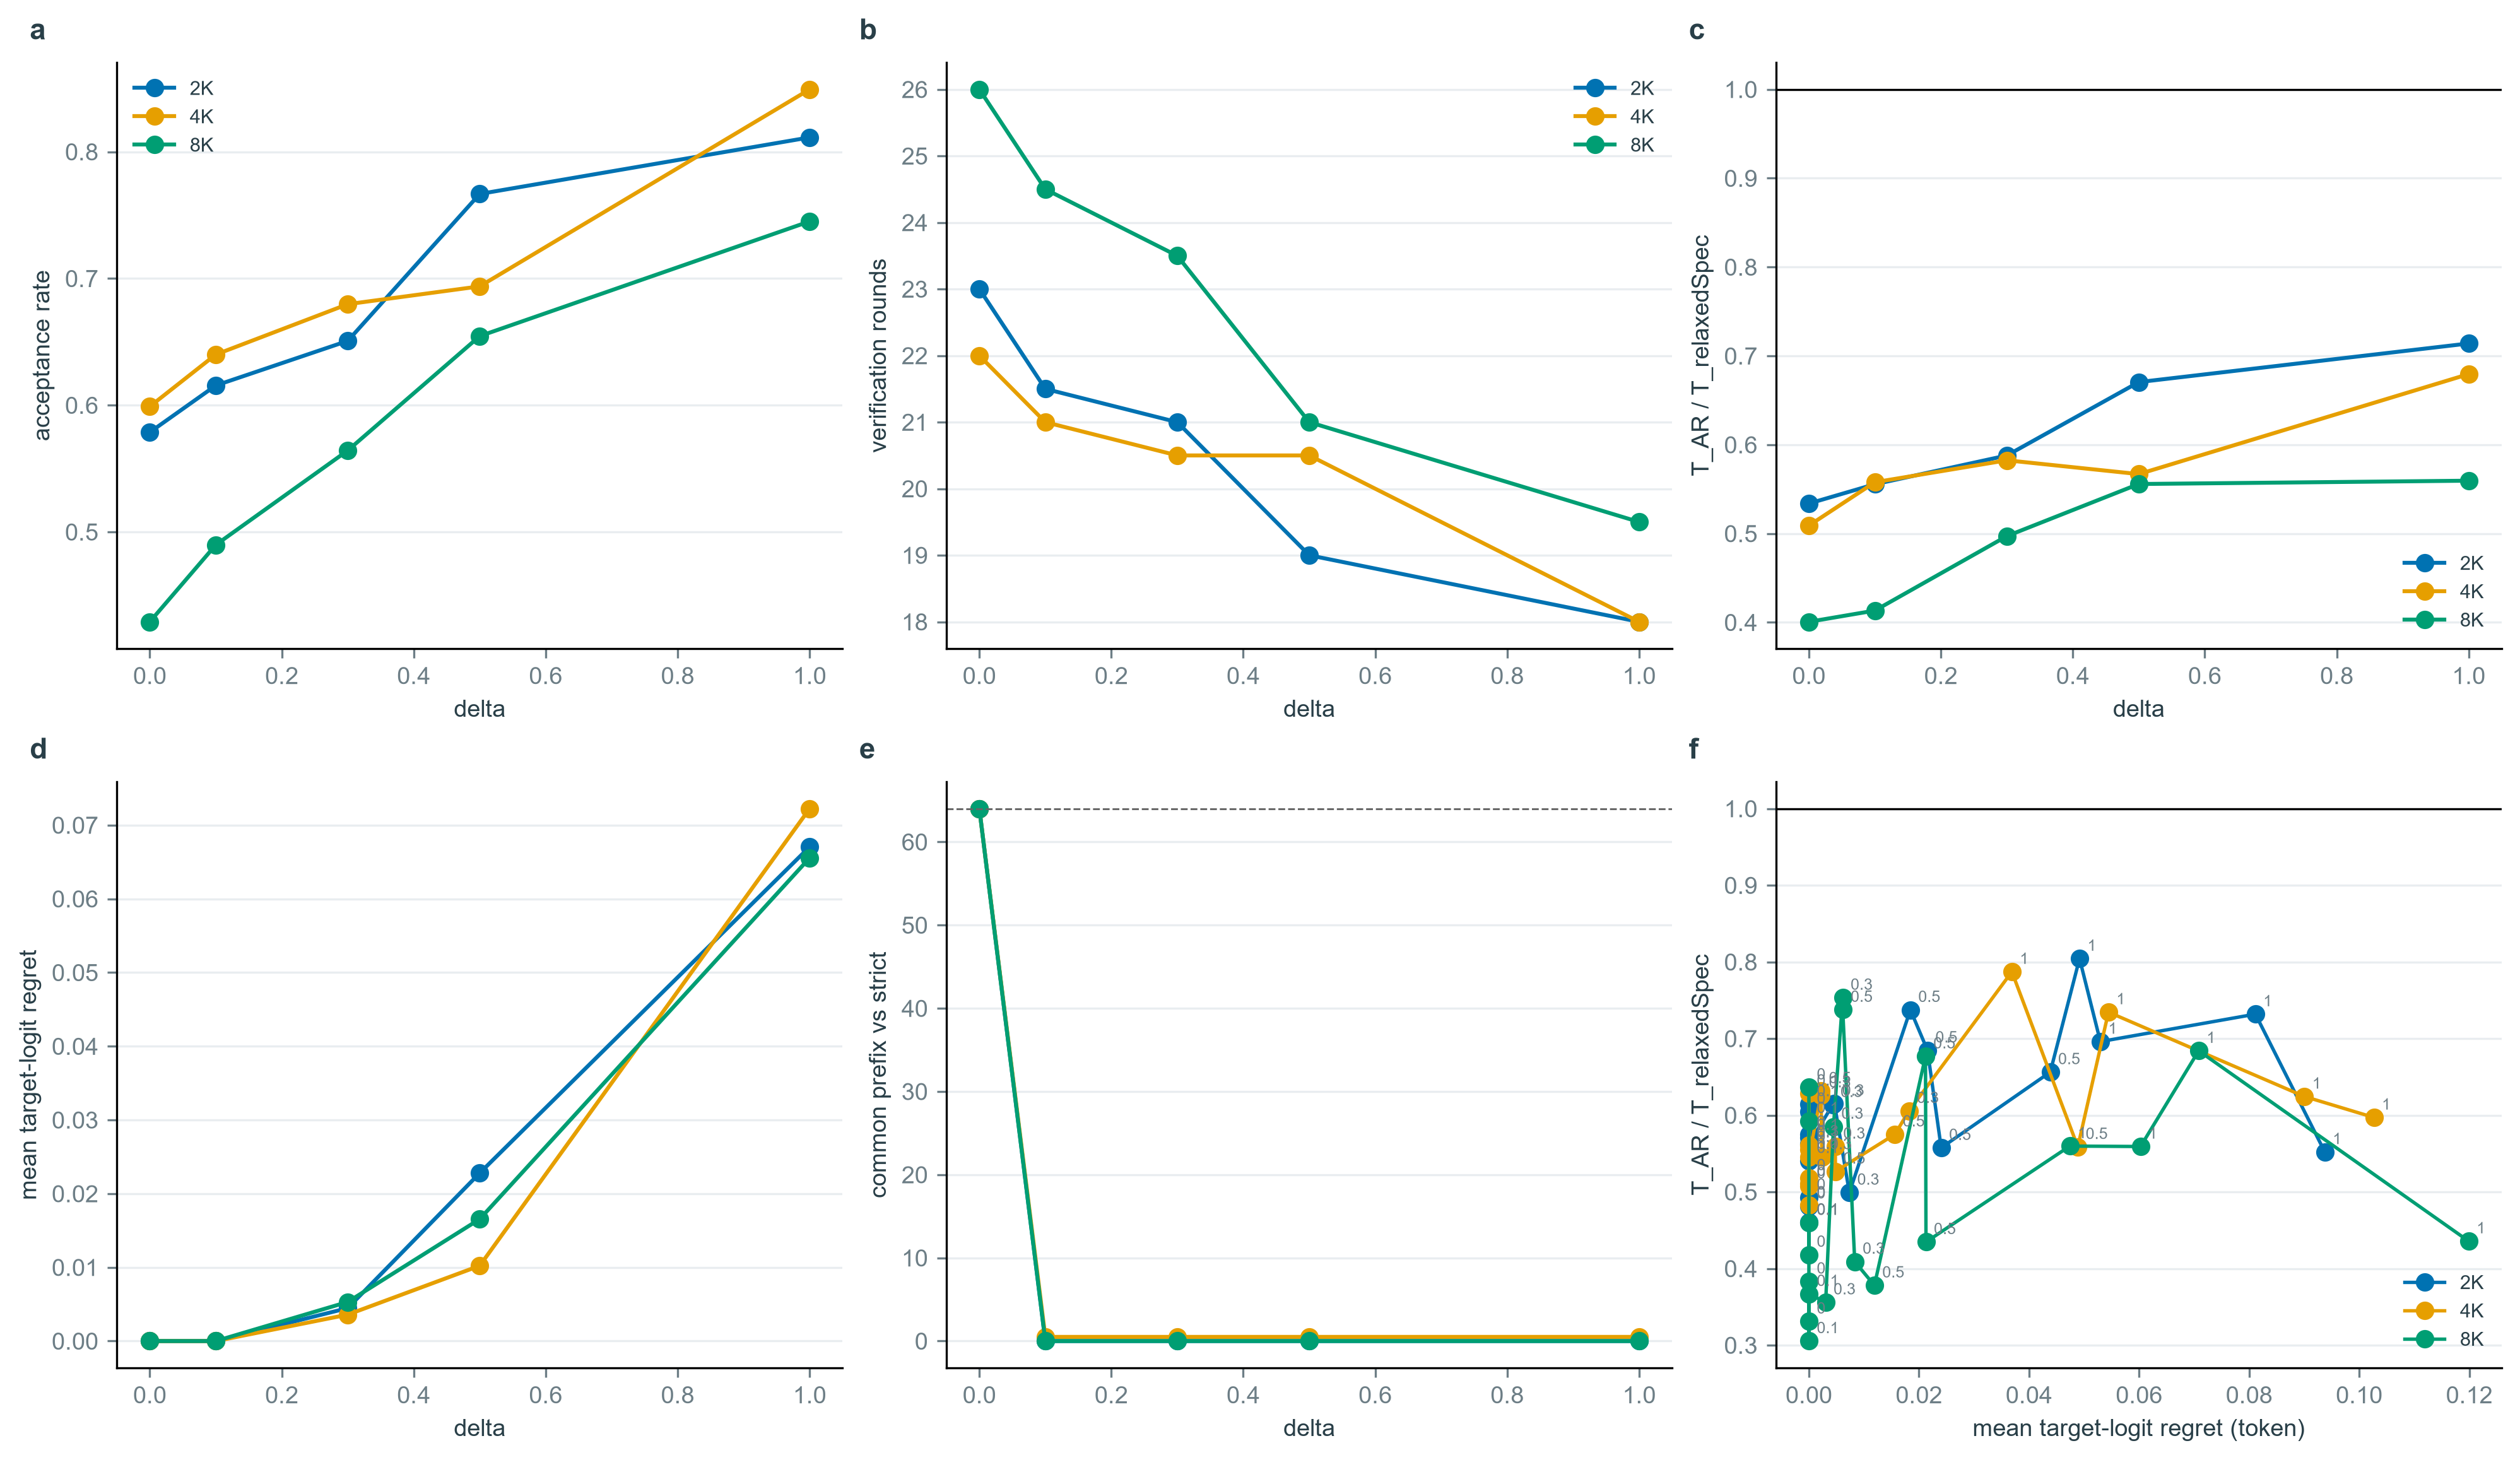
这说明“提高接受率”有收益,却还不足以跨过盈亏平衡点。
7.3 All-accept oracle:把接受率直接设为 1
为了隔离接受率的影响,项目构造诊断 oracle,强制所有候选通过。此时 acceptance = 1,仍得到:
| 上下文 | |
|---|---|
| 2K | 0.860 |
| 4K | 0.858 |
| 8K | 0.849 |
即使没有任何拒绝,SpecDec 仍慢约 14% 到 15%。因此,接受率不是充分条件。
加入 bonus token 后,每轮最多从 个输出提升到 个,轮数从约 16 降到 13, 提高到 0.912、0.931、0.874。个别 cross-batch cell 能达到 1.01 到 1.03,但这只是趋势证据,而且有一个 correctness gate 因 BF16 近似并列翻转而失败,不能包装成稳定加速结论。
7.4 CUDA Graph:局部很快,端到端却被显存限制
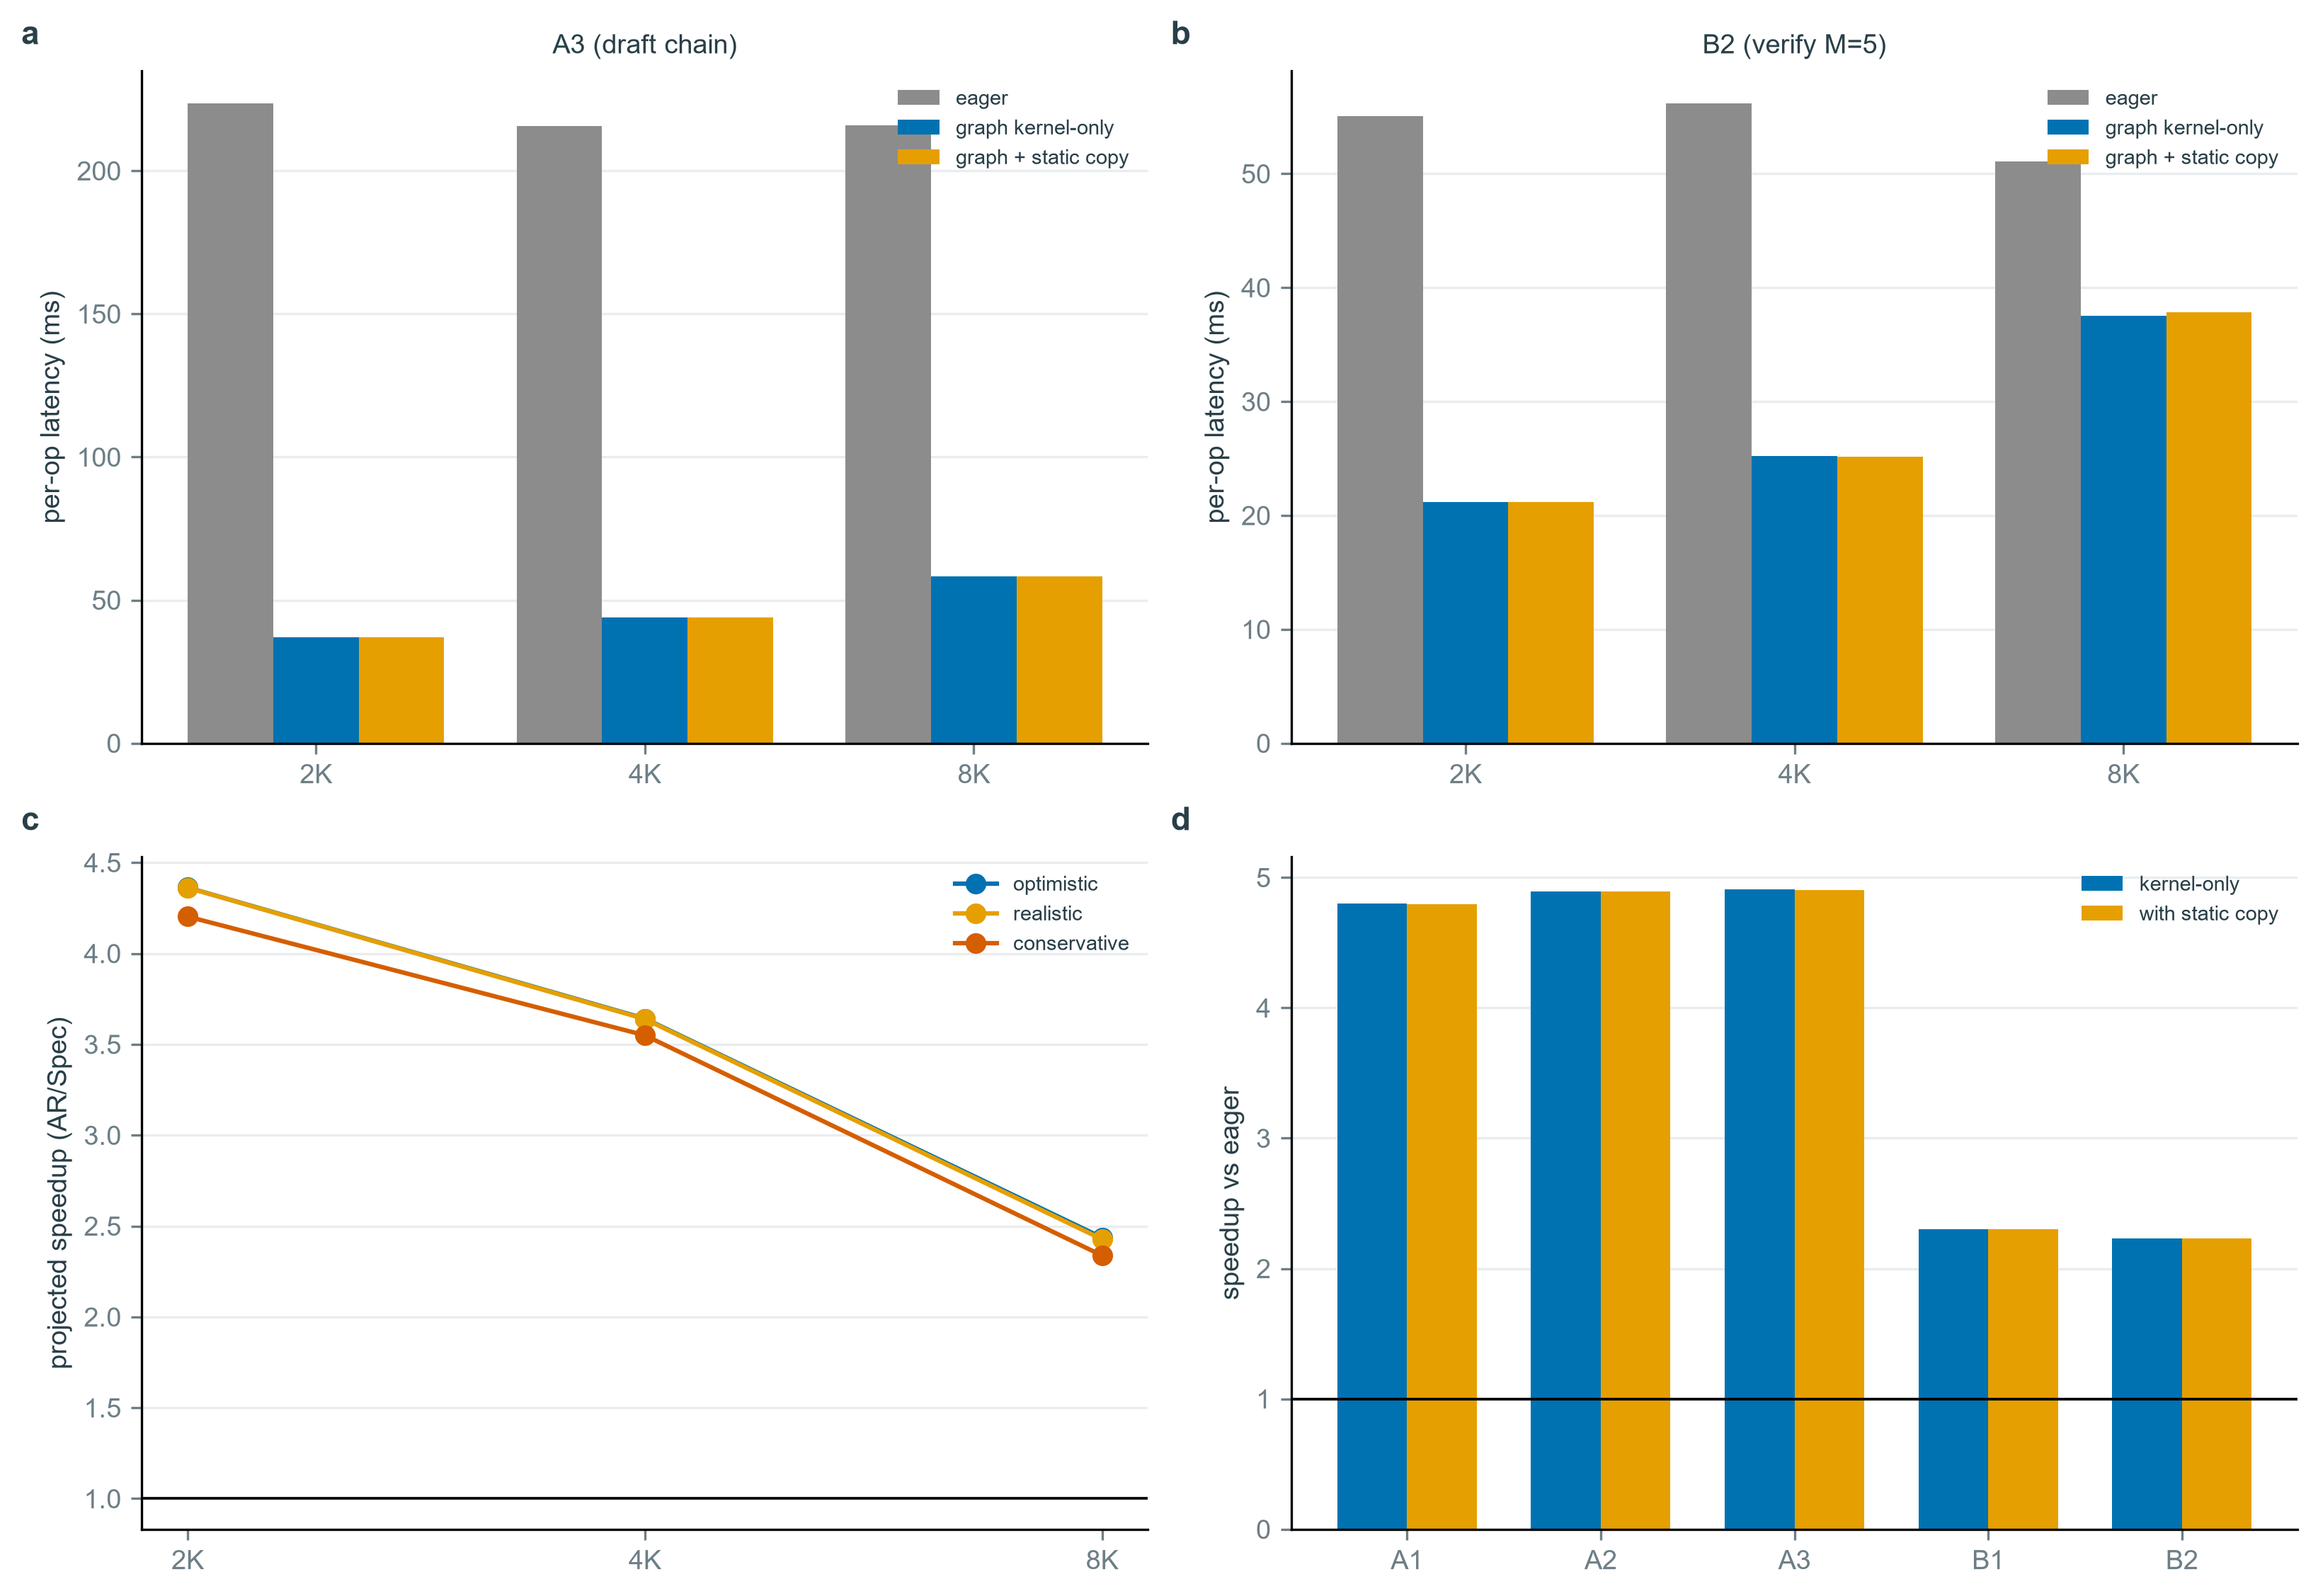
CUDA Graph 对固定形状的局部路径很有效:
- 草稿链局部加速约 3.7 到 6.0 倍;
- 目标验证局部加速约 1.4 到 2.6 倍。
问题在于图捕获会维护私有内存池。单个局部图池可能占约 2.0 GiB 或 0.89 GiB;按不同轮次和位置捕获 26 个端到端图,外推内存需求达到约 37.6 GiB。在 8 GB GPU 上,捕获到 8/26 时已经 OOM。
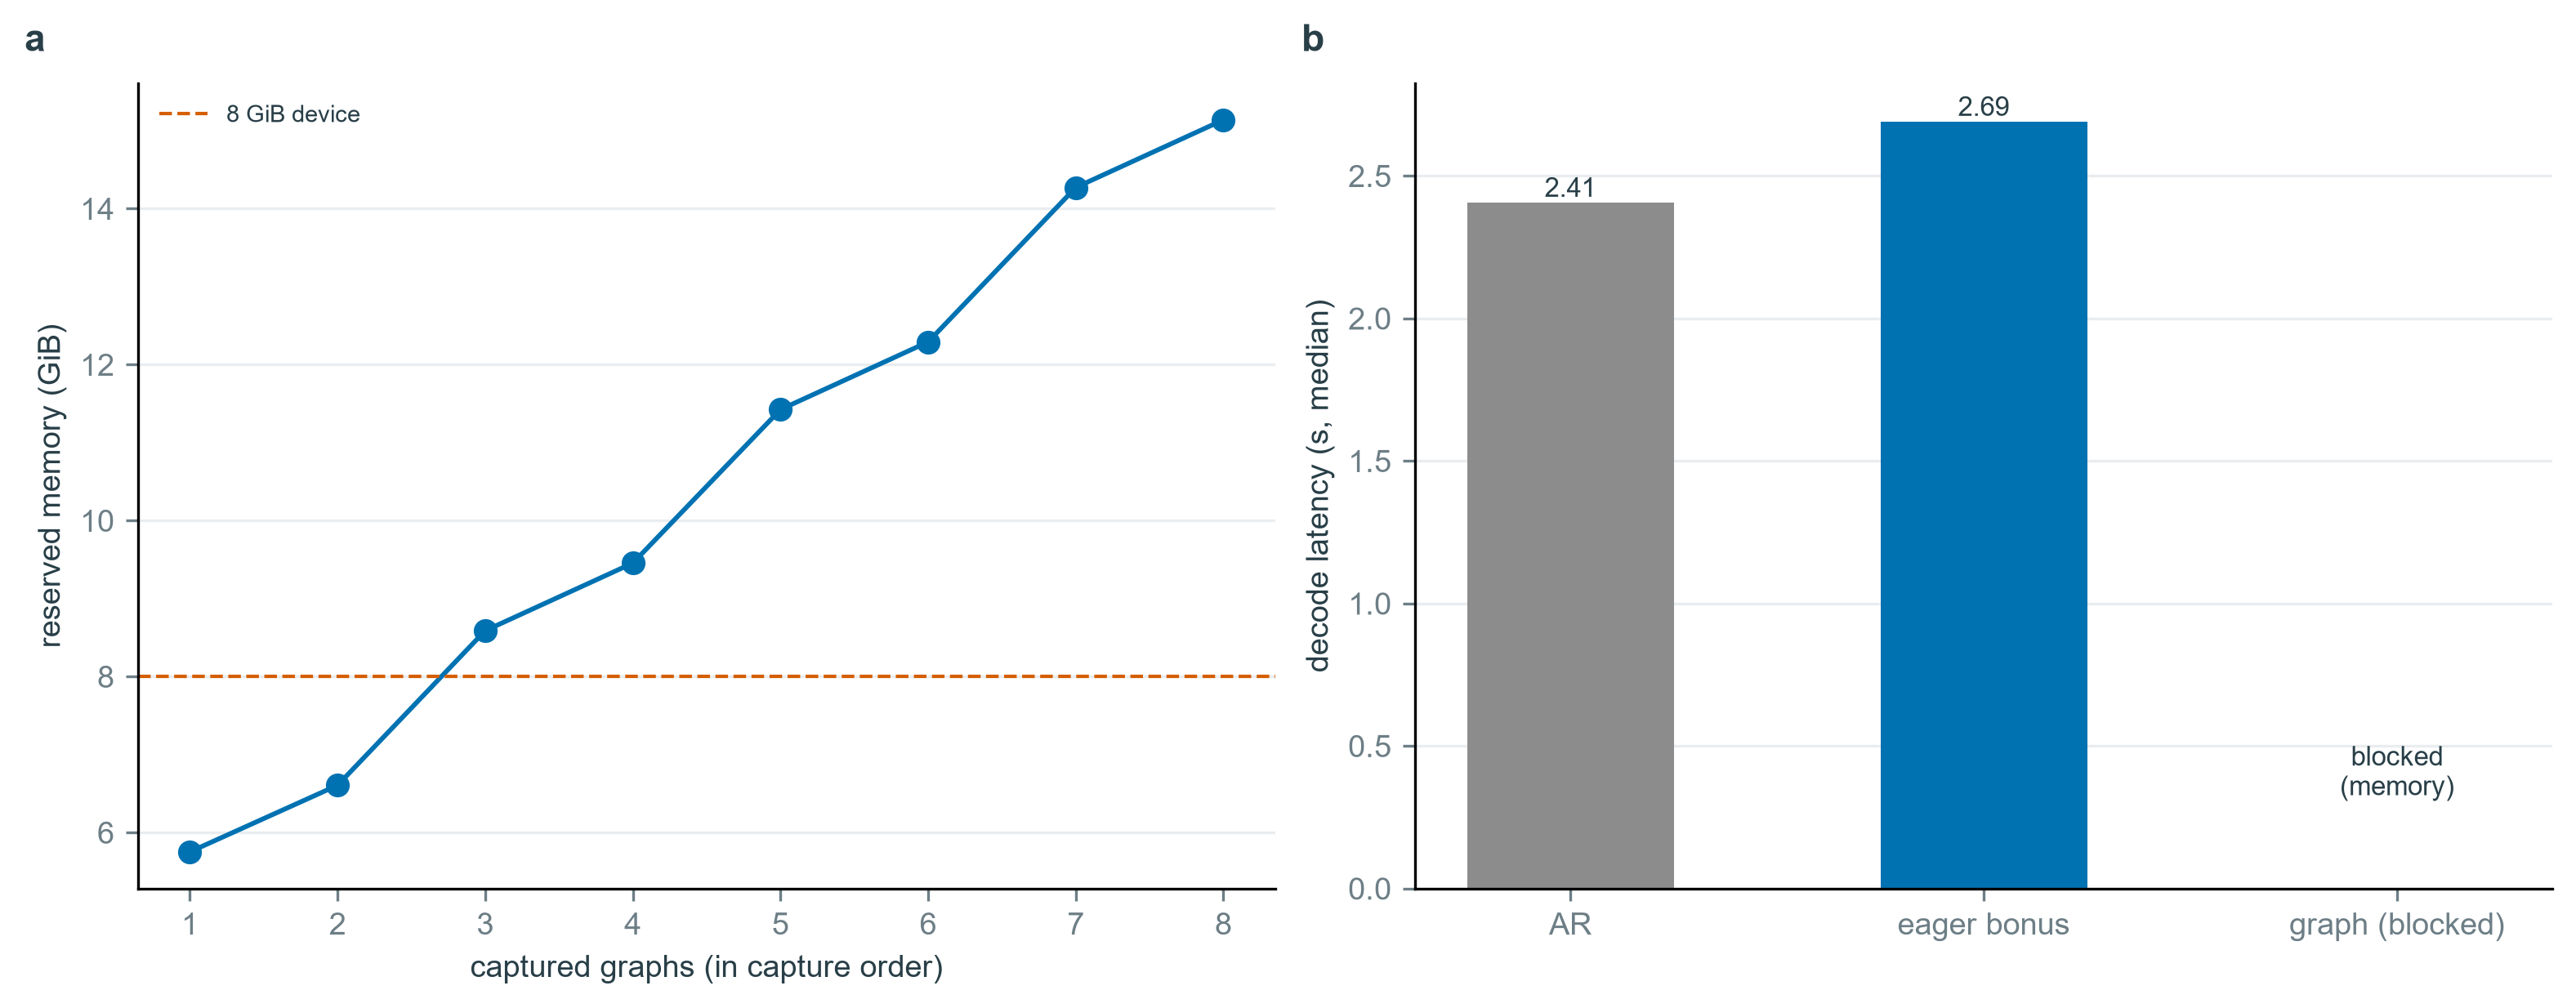
因此 CUDA Graph 不是“加一行配置”的免费优化。它要求稳定形状、可复用内存池和更精细的图设计;否则局部收益无法落到完整系统。
7.5 Draft-free oracle:移除草稿前向后发生了什么
最后一组实验保留 perfect acceptance 与 bonus token 的控制流,却移除真实草稿模型前向,用它测量“如果候选几乎免费”的理想上限。
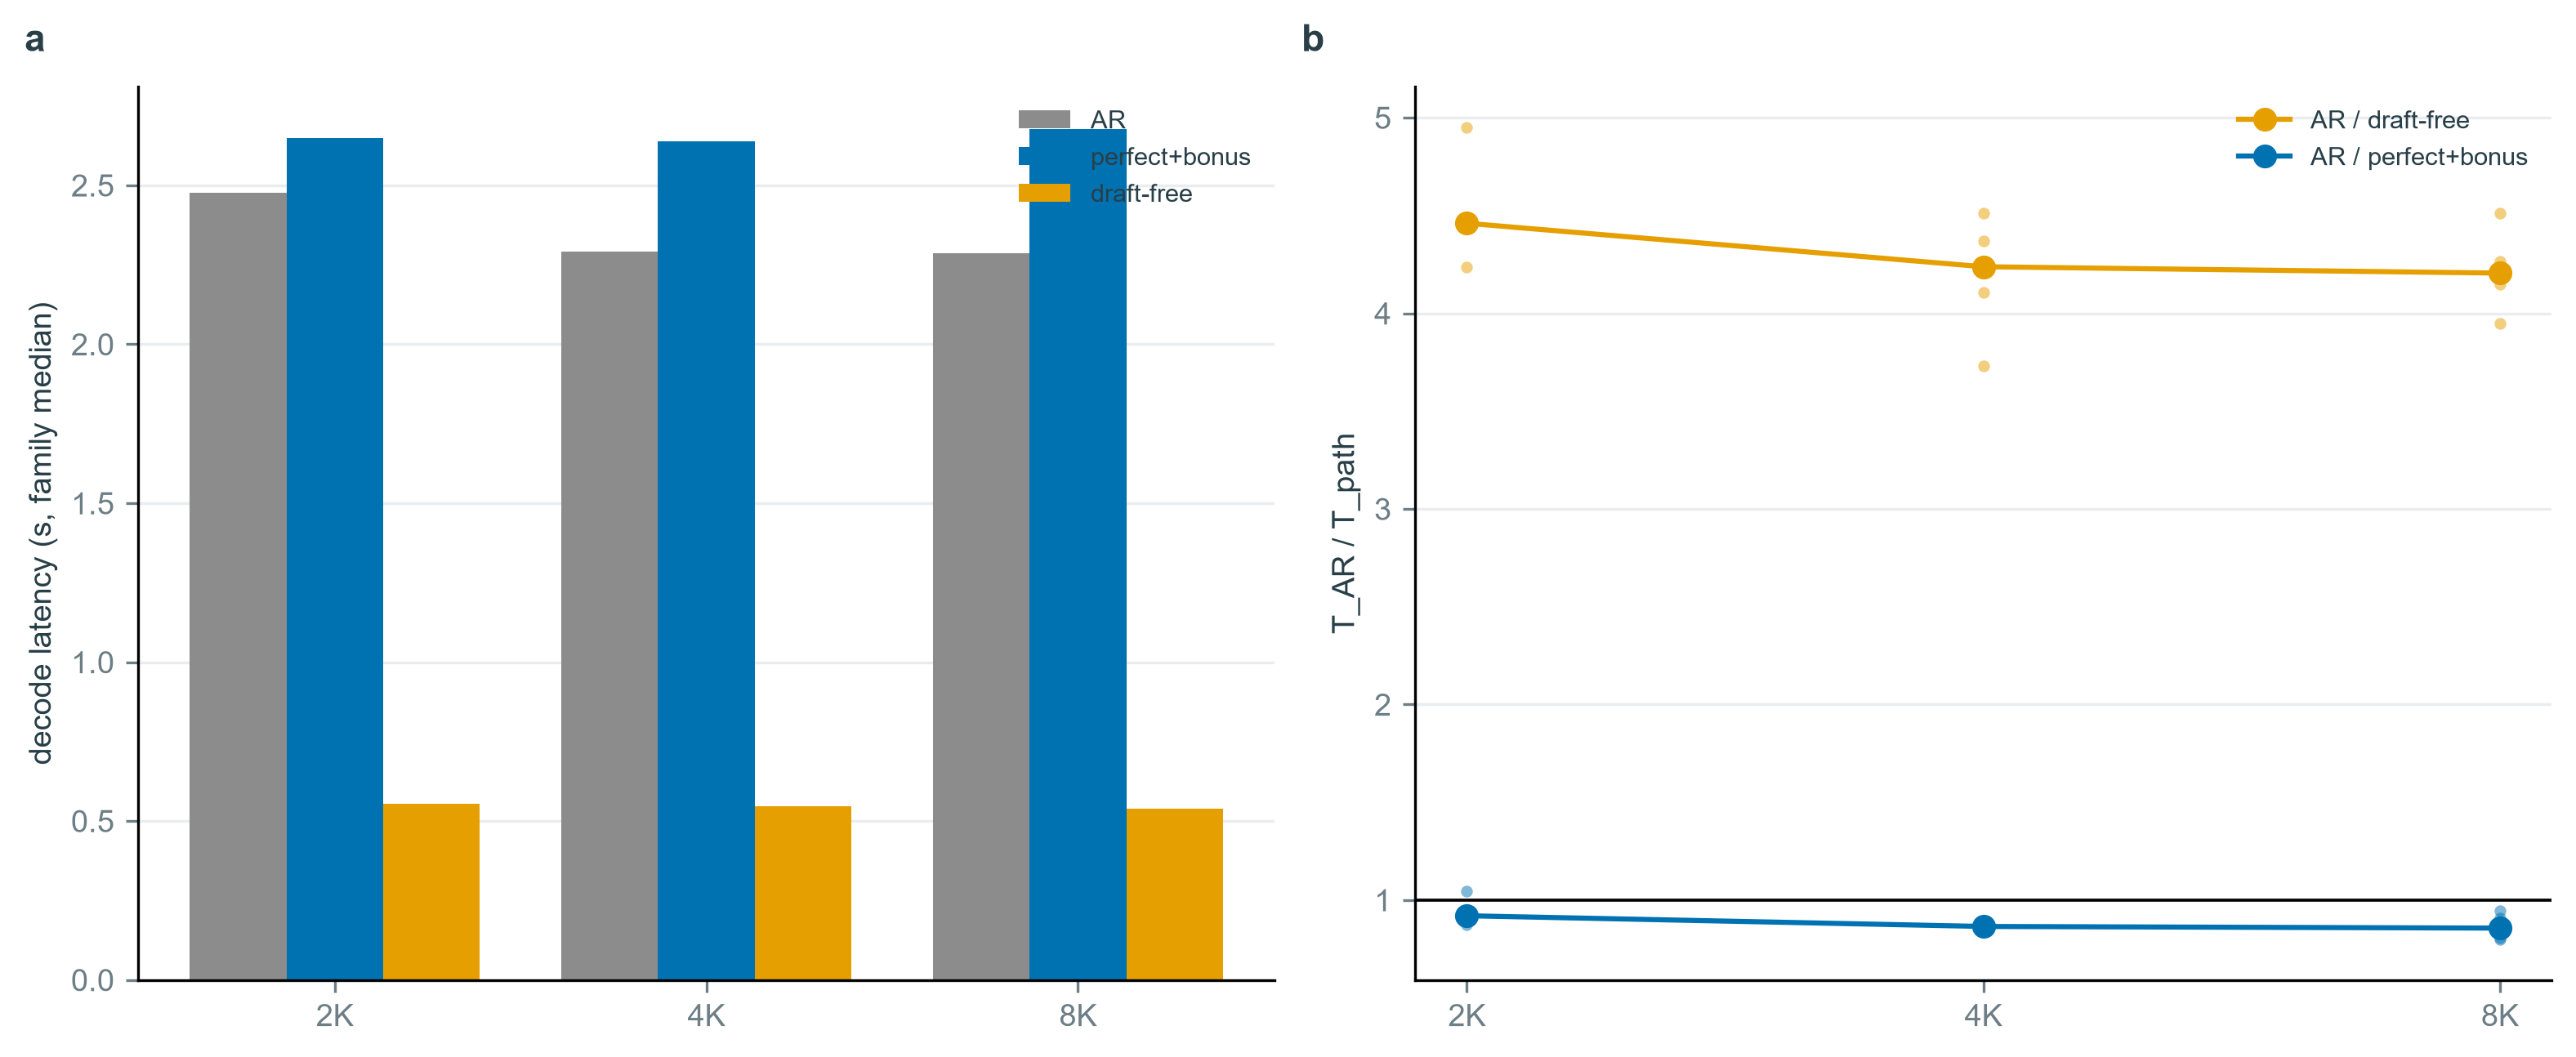
| 上下文 | AR | Draft-free oracle | 速度比 |
|---|---|---|---|
| 2K | 2.476 s | 0.555 s | 4.46x |
| 4K | 2.293 s | 0.545 s | 4.24x |
| 8K | 2.286 s | 0.540 s | 4.21x |
这不是可部署算法,因为它假设候选能够免费获得;但作为因果诊断,它非常有力:目标块验证和 cache 控制流本身具有超过 4 倍的潜在上限,真正吞掉收益的是独立草稿模型的逐 token 前向。
8. BF16 为什么让“精确一致”变得微妙
理论上的 greedy speculative decoding 与目标模型逐 token greedy 解码应输出相同 token。但理论隐含了一个条件:同一目标 logits 在串行形状 与块验证形状 下必须数值一致。
在 BF16 GPU kernel 中,矩阵形状变化可能改变归约顺序、kernel 选择和舍入误差。如果 top-1 与 top-2 logit 非常接近,极小数值差异就可能翻转 argmax。正式数据中,AR 与 SpecDec 的最终输出完全相同的 family 数分别只有 3/16、8/16、5/16,但每条路径自身是确定的。
这不意味着算法推导错误,而意味着工程系统应区分三层正确性:
- 算法正确性:在相同目标分布下,接受/拒绝规则是否保持目标输出;
- 数值一致性:不同 batch/block 形状是否产生足够接近的 logits;
- 应用等价性:最终文本在任务质量上是否可接受。
项目因此把 token equality 作为单独 correctness gate,而不是只检查程序有没有崩溃。
9. 项目做得好的工程实践
9.1 冻结设计后再跑确认性实验
模型、上下文、、最大生成长度、计时方法和排除规则都先冻结,再跑 held-out families。这样可以避免根据结果临时调参后又把同一批数据称为“验证”。
9.2 负结果后做机制分解
项目没有用更多 benchmark 掩盖失败,而是按以下顺序拆问题:
1 | 控制面开销 |
每一步只改变一个主要因素,因此结论比“换几个参数再跑”更清晰。
9.3 把测量有效性单独对待
8K 的失败 timing cells 没有被悄悄混进主结论;warmup、独立进程、AB/BA 顺序、family-level 配对与 bootstrap 也都有记录。性能工程中,实验协议和实现本身同样重要。
10. 怎样复现仓库实验
先克隆仓库并安装依赖:
1 | git clone https://github.com/RichardF123/SpecDec-Context-Scaling.git |
Windows PowerShell:
1 | .\.venv\Scripts\Activate.ps1 |
建议按仓库 README 的顺序执行,而不是直接从最大实验开始:
- 运行环境和模型加载 smoke test;
- 验证 AR 路径与 KV Cache 长度;
- 验证 SpecDec 的 token alignment 与 rollback;
- 运行小规模 correctness gate;
- 再运行 confirmatory benchmark 和分析脚本。
仓库中的关键目录包括:
1 | src/ 推理引擎、模型与 KV Cache 实现 |
具体命令可能随仓库继续更新,复现时应以 README 和冻结配置为准。
11. 这个项目真正得到的结论
这组实验不能证明“投机解码没有用”,它证明的是一个更窄但更有工程价值的命题:
在 RTX 4060 Laptop 8 GB、batch 1、Qwen2.5-1.5B 目标模型、Qwen2.5-0.5B 独立草稿模型、BF16、、最多生成 64 token 的冻结配置下,标准投机解码没有达到端到端加速;主要瓶颈是草稿模型前向成本,而非单纯的接受率或 Python 控制流。
这也指向了更合理的下一步:候选生成器不能只是“稍小一点的完整 Transformer”。更值得探索的是复用目标模型隐藏状态、只训练轻量预测头,或采用 feature-level speculation,例如 EAGLE 一类路线。它们试图从结构上降低 ,而不是只在接受规则上继续放宽阈值。
对一个推理优化项目而言,最重要的产物不是某个孤立 speedup 数字,而是知道每个数字在什么系统边界下成立、为什么成立,以及下一次优化应该砍向哪一项成本。
参考资料
- SpecDec-Context-Scaling 项目仓库
- Yaniv Leviathan, Matan Kalman, Yossi Matias. Fast Inference from Transformers via Speculative Decoding, ICML 2023.
- Charlie Chen et al. Accelerating Large Language Model Decoding with Speculative Sampling, 2023.
- Yuhui Li et al. EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty, ICML 2024.
- Tianle Cai et al. Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads, 2024.
SpecDec-Context-Scaling 项目解读:8GB GPU 上投机解码为什么没有加速
https://richardf123.github.io/2026/11/01/specdec-context-scaling-project-guide/