投机解码教程:从概率保持、KV Cache 回滚到性能盈亏平衡
投机解码(Speculative Decoding)常被概括为一句话:小模型先猜,大模型一次验证多个 token。 这句话说明了直觉,却没有回答实现中最关键的四个问题:为什么一次前向能够验证多个候选?拒绝候选后怎样保证采样分布不变?KV Cache 应该回滚到哪里?为什么接受率很高仍然可能更慢?
本文从普通自回归解码出发,推导 greedy 与 sampling 两类投机解码,给出 logits 对齐、cache 修复、期望推进长度和成本模型,并结合 SpecDec-Context-Scaling 的实验说明如何判断一个投机解码系统是否真的赚到了时间。
1. 为什么 LLM 解码慢
1.1 Prefill 与 Decode 是两种不同工作负载
Transformer 推理通常分为两个阶段:
- Prefill:一次处理整段 prompt,生成每层的 Key/Value Cache;
- Decode:每次输入一个新 token,读取历史 KV,生成下一个 token,再把新 KV 追加到 cache。
设 prompt 长度为 ,要生成 个 token。没有 KV Cache 时,每一步都要重新计算整个前缀;有 cache 后,历史 token 的 K/V 不必重复生成,但 decode 仍然有严格的因果依赖:
在得到 之前,无法确定计算 时的条件。因此生成 个 token 通常需要 次串行目标模型调用。
1.2 Decode 往往受内存带宽限制
batch size 较小时,每次 decode 都要读取大量模型权重,却只计算一个或少量 token。矩阵乘法的算术强度不高,GPU 计算单元难以充分利用,时间更多消耗在权重与 KV 的数据搬运上。
如果能在一次目标模型前向中处理 个待验证 token,权重读取可以服务更多 token,GPU 并行度也更高。投机解码就是通过一个便宜的候选生成器,尝试把串行 decode 改造成小块验证。
2. 基本角色与记号
设:
- :目标模型 target 在前缀 下的分布;
- :草稿模型 draft 在同一前缀下的分布;
- :每轮最多提出的候选数;
- :草稿候选;
- :本轮被接受的连续候选数。
一轮投机解码有四个阶段:
1 | Draft proposal |
“连续”很重要。如果 被拒绝,即使 恰好等于目标模型在另一个前缀下的选择,也不能越过 直接接受,因为 的条件已经不再成立。
3. Greedy 投机解码
先讨论温度为 0 的 greedy decoding。普通目标模型选择:
3.1 草稿阶段
从当前已提交前缀 出发,草稿模型串行生成:
草稿仍是自回归的,所以这一步通常包含 次小模型 decode。
3.2 目标模型为什么能一次验证 个 token
把 整块送入目标模型,并使用 causal mask。块中位置 只能看到:
看不到未来的 。因此一次前向可以同时得到每个候选前缀后的 logits。这和训练时用 teacher forcing 一次计算整段 token 的原理相同。
关键区别是:这些 logits 只有在前面的候选都被接受时才对应真实生成路径。所以验证必须从左到右寻找最长匹配前缀。
3.3 具体例子:
假设草稿提出:
1 | [the, model, runs, fast] |
目标 greedy 路径依次认为:
1 | [the, model, is, ...] |
前两个 token 匹配,第三个不匹配。本轮提交:
1 | [the, model, is] |
其中 the, model 来自草稿候选,is 是目标模型在第一个分歧位置的 replacement。runs, fast 必须丢弃。
相比普通 AR 的三次目标调用,这一轮用一次 target block verification 推进了三个 token。但是否更快还取决于生成四个草稿候选花了多久。
4. 最容易出错的 logits 对齐
假设进入本轮前,目标模型已经保存了对下一个 token 的预测 saved_next。把 个候选送入目标模型后得到:
1 | rows.shape == [k, vocab_size] |
因果语言模型在输入位置 输出的是“看到该位置 token 之后”的下一个 token 分布。因此正确对齐为:
| 被验证候选 | 应使用的目标 logits |
|---|---|
saved_next |
|
rows[0] |
|
rows[1] |
|
rows[k-2] |
|
| 全接受后的 bonus | rows[k-1] |
伪代码如下:
1 | accepted = 0 |
这里 block_logits[i] 在接受 后用于判断 。如果直接用 block_logits[i] 判断 ,验证条件就向后错了一位。
5. KV Cache:投机解码真正难写的部分
目标模型和草稿模型各有一套 KV Cache。它们的张量内容不同,但在每轮结束后必须表示同一个已提交序列。
5.1 建议维护的核心不变量
1 | target_cache.length == draft_cache.length == committed_sequence.length |
对于常见 Hugging Face cache,token 长度维通常是 dim=2,但不要在所有模型上盲目硬编码,最好由 cache adapter 封装。
5.2 部分接受时怎样回滚
设进入本轮前长度为 ,草稿临时写入了 个候选,目标也验证了整个 block。若只接受前 个,并由目标给出 replacement :
- 两份 cache 都裁剪到 ;
- 将 分别送入 target 和 draft;
- 两份 cache 都变为 ;
- 保存 target 对下一个位置的 logits。
伪代码:
1 | target_cache.trim(t + m) |
常见错误包括:
- 只回滚 draft cache,没有回滚 target cache;
- 把 cache 裁到 后又输入 replacement,导致重复写入;
- 被拒绝候选仍留在某一层 cache;
- EOS 出现在候选块中时仍把后续 token 写入 cache;
- target 与 draft 使用了不同的 position ids。
5.3 全接受与 bonus token
如果 个候选全部通过,rows[k-1] 已经是条件在 下的目标 logits。可以从中再取一个目标 token :
于是一次 target verification 最多提交 个 token。这个 bonus 很重要,因为它提高了每轮推进长度,却不需要再调用一次 target;之后仍要让 draft 消费 ,使两份 cache 对齐。
6. Greedy 版本为什么保持目标输出
在精确算术下,可以按位置归纳:
- 若草稿 token 等于目标 greedy token,接受它与直接运行目标模型相同;
- 第一个不相等位置改用目标 token,因此该位置也与目标 greedy 路径相同;
- 修复后,两份 cache 都对应完全相同的已提交前缀,下一轮继续成立。
所以 greedy SpecDec 是目标 greedy decoding 的无损加速方法。
但工程上还要加一句限定:目标模型对相同语义前缀的数值结果必须足够一致。 串行 decode 的矩阵形状与 block verification 不同,BF16 下可能使用不同 kernel 或归约顺序。当 top-1 和 top-2 极接近时,微小舍入误差会翻转 argmax。因此测试时要同时检查算法不变量与最终 token equality。
7. Sampling 投机解码:怎样精确保持分布
采样版本不能简单地比较 argmax。目标是让最终输出仍严格服从 ,同时尽量复用从草稿分布 抽到的候选。
为简化记号,先看某一个位置,并省略条件前缀。
7.1 接受概率
先从草稿分布采样 ,然后以概率
接受它。当 时这个 token 不会被草稿采到;实现中仍应对除零和极小概率做数值保护。
候选 被草稿抽中且被接受的概率质量为:
这部分正是 与 的重叠质量。
7.2 拒绝后为什么不能直接从 重采样
如果拒绝后再从完整 采样,那么重叠部分会被计算两次,最终分布会偏离目标。正确做法是从残差分布采样:
其中 。
总拒绝概率为:
因此 token 从拒绝修正路径得到的无条件概率质量为:
再加上接受路径:
这就证明了最终 token 的边缘分布恰好是目标分布 。
7.3 多 token 情况
对 从左到右重复上述检验。每个位置的 和 都条件在已经接受的前缀上:
一旦某个位置拒绝,就从该位置的残差分布生成 replacement 并停止验证后续候选。若全部接受,再从最后一行目标分布采样 bonus token。逐位置条件分布都保持正确,因此整个生成序列仍服从目标模型。
8. 期望一轮能推进多少 token
为了获得直觉,假设每个候选独立地以概率 被接受。真实系统中的接受事件并不独立, 也会随位置变化,所以这里只是近似模型。
第 个候选被提交,意味着前 个候选全部通过,概率为 。因此每轮接受的草稿 token 期望数为:
标准算法在第一次拒绝时会提交一个 replacement;全部接受时可提交一个 bonus。若两种情况都计入一个额外目标 token,则本轮期望提交量近似为:
例如 、:
虽然一轮最多能推进 5 个 token,平均却不到 2 个。把 加大也不是无限有利:后部候选被执行到的概率按 衰减,但生成它们的 draft 成本仍然要付。
9. 性能盈亏平衡:接受率高不等于会加速
记:
- :draft 单 token decode 成本;
- :target 普通单步 decode 成本;
- :target 验证 个候选的成本;
- :拒绝后的修复成本;
- :采样、同步、cache 管理等开销。
一轮投机解码期望成本可写为:
平均每个输出 token 的成本是:
只有满足
时,投机解码才会带来端到端加速。
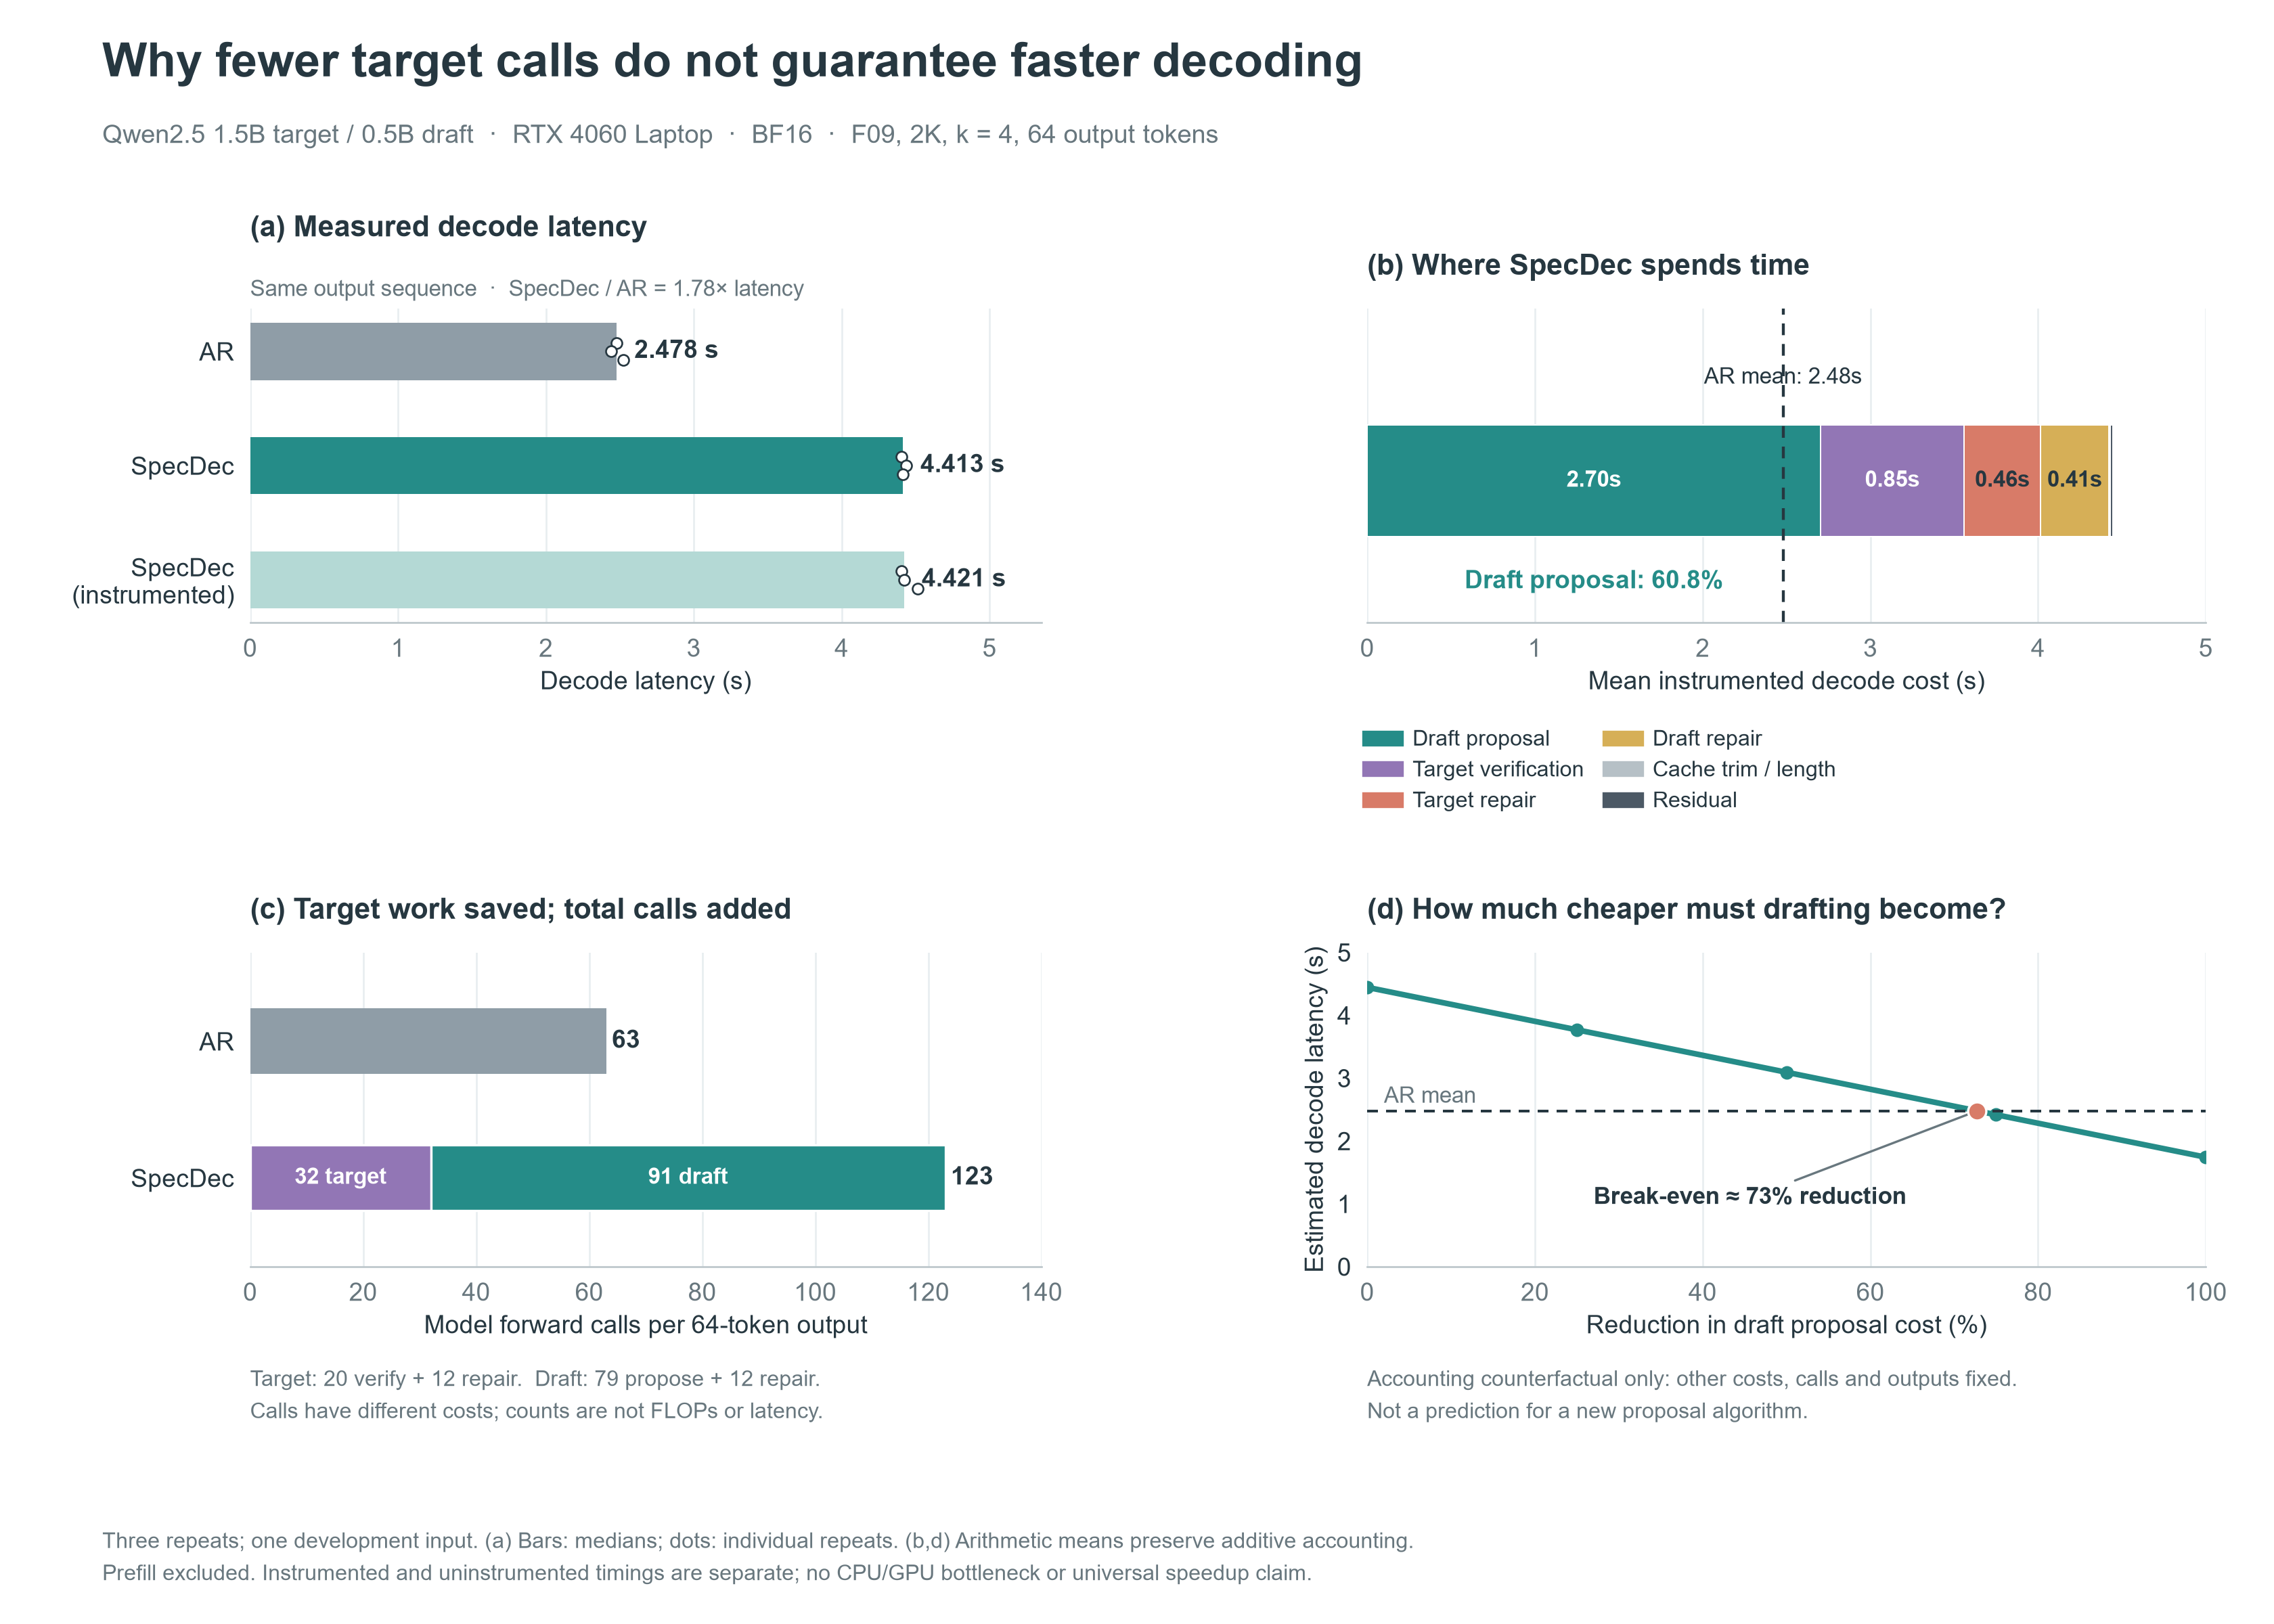
这条不等式解释了几个常见误区:
- 目标调用减少不保证更快。 可能比节省的 target 时间更大。
- 接受率提高不保证更快。 它主要提高 ,却没有消除 draft 成本。
- 小模型不一定足够小。 目标是 1.5B 时,0.5B 已经占目标参数量的三分之一。
- 局部 kernel 加速不等于端到端加速。 图捕获、动态形状和显存池都可能吞掉收益。
- 最优 与系统有关。 更大的 提高最大推进量,也增加 draft、verification 和浪费候选的成本。
10. 上下文长度怎样影响结果
随着上下文增长,decode 阶段每一步要读取更长的 KV Cache。直觉上,target 单步会变贵,块验证也可能更有价值;但 draft 同样拥有自己的 KV Cache,也要读取更长上下文。
每层 KV Cache 大小可粗略写成:
其中:
- 表示 Key 和 Value;
- 是层数;
- 是缓存序列长度;
- 是 KV heads 数;
- 是每个 head 的维度;
- 是每个元素字节数。
投机解码通常要同时保存 target 与 draft 的 cache,所以长上下文还会压缩可用于 CUDA Graph、工作区和更大 batch 的显存。上下文变长是否帮助 SpecDec,取决于 target 与 draft 的成本增长速度、KV 组织、验证 kernel 和显存压力,不能只凭“长上下文更慢”推断。
在 SpecDec-Context-Scaling 的 8 GB 实验中,2K、4K、8K 都未出现总体加速,说明该模型对的 draft 成本没有被上下文增长自然摊薄。
11. 一个最小实现框架
下面的伪代码突出控制流,不包含温度、top-p、EOS、padding 和多 batch 细节:
1 | def speculative_greedy(target, draft, prompt, k, max_new_tokens): |
真实实现还要处理一个问题:verify_block 已经把候选写入 target cache,不能假设 target.step(bonus) 前的 cache 状态与伪代码完全相同。工程上应明确区分“临时验证长度”和“已提交长度”,并让 cache API 决定何时 trim、何时复用最后一行 logits。
12. 测试顺序:先证明正确,再谈速度
12.1 Cache 单元测试
- append 一个 token 后长度恰好加 1;
- trim 到任意合法长度后,各层 K/V 一致;
- trim 后重新追加,结果与从该前缀重新 prefill 接近;
- target 与 draft 每轮结束长度一致。
12.2 对齐测试
使用一个很短的固定序列,分别运行:
- target 串行 decode;
- target 对同一序列 block forward;
- SpecDec verification。
打印每个位置所使用的前缀、候选、目标 token 和 logits 行号,专门排查 off-by-one。
12.3 正确性门槛
Greedy 路径至少检查:
- 固定输入是否确定;
- AR 与 SpecDec token 是否相等;
- 若不相等,top-1/top-2 gap 是否接近数值精度;
- EOS、最大长度与拒绝位置是否一致。
Sampling 路径不能逐 token 要求相等,应在小词表或可控分布上重复采样,比较经验频率与目标分布,并验证随机数种子管理。
12.4 性能测量
- prefill 与 decode 分开计时;
- 丢弃 warmup;
- 使用 CUDA Event 或在 wall time 前后正确同步;
- 记录 proposal、verification、repair、同步各部分时间;
- 报告中位数、分位数与 paired ratio;
- 同时记录 acceptance、每轮提交数、target calls 和峰值显存。
仅报告 tokens/s 不足以解释为什么快或慢。
13. 常见优化方向
13.1 让 draft 真正便宜
最直接的方向不是一味追求更高接受率,而是降低 :
- 更小的独立草稿模型;
- 量化 draft 权重与 KV;
- 共享词表、embedding 或部分计算;
- 使用目标模型隐藏状态上的轻量预测头;
- n-gram / prompt lookup 等无模型候选。
13.2 减少每轮固定开销
- 将接受判定留在 GPU;
- 避免每个 token
.item()触发同步; - 预分配 token 与 cache buffer;
- 合并小 kernel;
- 对固定形状路径使用 CUDA Graph,但审计图内存池。
13.3 提高验证并行度
- tree speculation 同时验证多个候选分支;
- 多 decoding heads 一次预测多个未来位置;
- 动态选择 ,在低置信度位置缩短候选块;
- 根据请求 batch、上下文和显存选择是否启用 speculation。
14. 相关方法怎样理解
| 方法 | 候选从哪里来 | 核心取舍 |
|---|---|---|
| 经典 SpecDec | 独立小语言模型 | 通用,但要支付完整 draft forward |
| Prompt lookup / n-gram | prompt 或历史片段 | 几乎无模型成本,适合重复文本 |
| Medusa | 目标模型上的多个 decoding heads | 减少独立 draft 成本,需要额外训练 |
| EAGLE | 在特征层预测未来状态/token | 候选更便宜、接受率高,实现更复杂 |
| SpecInfer | 多候选与 tree verification | 提高验证并行度,需要树结构与 mask 管理 |
这些方法都在优化同一条不等式,只是选择了不同杠杆:降低候选成本、提高接受率、增加每轮输出,或降低验证与控制开销。
15. 一套实用判断框架
在决定是否给系统加入投机解码前,可以依次回答:
- target decode 当前是带宽受限、计算受限,还是调度受限?
- 候选生成器相对 target 到底便宜多少,而不只是参数少多少?
- 在真实请求上,连续接受长度分布是什么?
- target block verification 的 随 怎样变化?
- 两份权重与 KV Cache 是否挤压 batch、图捕获或其他优化?
- 应用要求 token-exact、distribution-exact,还是只需质量近似?
- 加速是否在 paired benchmark 上稳定,而不只是一个 prompt 的最好值?
投机解码不是“免费并行化”,而是一笔交易:用便宜候选换取更少的昂贵串行步骤。真正困难的地方,是让候选足够便宜、足够准确,并让验证和缓存管理不把理论收益重新吃掉。
参考资料
- Yaniv Leviathan, Matan Kalman, Yossi Matias. Fast Inference from Transformers via Speculative Decoding, ICML 2023.
- Charlie Chen et al. Accelerating Large Language Model Decoding with Speculative Sampling, 2023.
- Xupeng Miao et al. SpecInfer: Accelerating Generative Large Language Model Serving with Tree-based Speculative Inference and Verification, 2023.
- Tianle Cai et al. Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads, 2024.
- Yuhui Li et al. EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty, ICML 2024.
- SpecDec-Context-Scaling 项目与实现文档
投机解码教程:从概率保持、KV Cache 回滚到性能盈亏平衡
https://richardf123.github.io/2026/11/01/speculative-decoding-from-principles-to-implementation/