统计学不是一份需要背诵的公式清单。它真正研究的是:面对带有随机性、噪声和有限样本的数据,我们怎样描述现象、量化不确定性,并对总体作出有边界的判断。
本文根据 AMA2634 Introduction to Statistics 的 10 讲课程资料整理,主线是:
1
2
3
4
5
6
7
8
9
数据与抽样 -> 描述统计 -> 概率模型 -> 随机变量与分布 -> 抽样分布和中心极限定理 -> 参数估计 -> 假设检验 -> 两总体比较 -> 相关与回归
读完以后,不仅应该会代公式,还应该能判断:为什么采用这个统计量、公式依赖什么假设、结论可以说到什么程度,以及什么时候不能使用它。
下面的课程讲义可以和正文配合阅读。建议先读对应章节,再用讲义中的例题检查自己是否真正理解了定义、假设与计算过程。
课程资料仅作为配套复习材料使用。完整教材未随文章公开上传;正文已经独立整理了核心概念和推导,不依赖下载资料也可以连续阅读。
统计学通常分成两部分。
描述统计 只描述手头已有的数据,包括:
频数表、直方图、箱线图;
均值、中位数、众数;
方差、标准差、四分位距;
数据分布的中心、离散程度和形状。
推断统计 则从样本出发,对总体作出带有不确定性的判断,包括:
用样本均值估计总体均值;
构造置信区间;
检验某个总体参数是否等于指定值;
比较两个总体的均值、比例或方差;
分析变量之间的关系并进行预测。
两者的差别可以写成:
1
2
描述统计:What happened in this dataset? 推断统计:What can this sample tell us about the population?
总体 Population :研究对象的全集。样本 Sample :从总体中抽取的一部分对象。参数 Parameter :描述总体的数值,例如总体均值 μ \mu μ σ 2 \sigma^2 σ 2 统计量 Statistic :只由样本计算的数值,例如样本均值 X ˉ \bar X X ˉ S 2 S^2 S 2
推断统计的基本矛盾是:总体参数未知,但我们只能观察有限样本。因此统计量本身也是随机变量,不同样本会得到不同结果。
选择图表、统计量和检验方法之前,必须先判断变量类型。
定性变量 Categorical Variable 表示类别:
定量变量 Quantitative Variable 表示数值:
定量变量还能分为:
离散变量:取可数值,例如订单数、事故次数;
连续变量:可在区间中取任意值,例如温度、时间、重量。
尺度
特征
示例
合适统计量
Nominal
只有类别,没有顺序
血型、地区
频数、众数
Ordinal
有顺序,间距不一定相等
满意度、等级
中位数、分位数
Interval
差值有意义,没有真实零点
摄氏温度
均值、标准差
Ratio
有真实零点,比例有意义
收入、重量、年龄
所有常用统计量
不能对名义变量计算“平均类别”,也不能因为满意度编码为 1-5,就自动假设 1 到 2 与 4 到 5 的心理距离相同。
统计模型只能处理已经收集到的数据,不能自动修复糟糕的抽样设计。
简单随机抽样 :每个个体被抽中的概率相同。系统抽样 :随机选择起点,每隔 k k k 分层抽样 :先按重要特征分层,再从每层抽样。整群抽样 :先随机抽取若干群组,再调查群组中的个体。
如果总体中不同群体差异明显,分层抽样通常比同样样本量的简单随机抽样更稳定。例如调查大学生消费时,可以按年级分层,避免样本几乎全来自大一学生。
观察研究只记录自然发生的数据;实验研究主动施加处理,并尽量随机分配受试者。
如果发现“喝咖啡的人学习时间更长”,不能直接推出咖啡导致学习时间增长。专业、考试压力和作息习惯都可能是混杂变量。
原始数据通常难以直接阅读,需要经过整理:
1 Raw Data -> Frequency Table -> Graph -> Numerical Summary
对跨度较大的连续数据,可划分为若干组。若数据范围为 R = x max − x min R=x_{\max}-x_{\min} R = x m a x − x m i n k k k
w ≈ R k . w \approx \frac{R}{k}.
w ≈ k R .
合理的分组需要满足:互斥、连续、穷尽,通常使用相同组宽。分组会损失信息,所以只应当用于展示,而不是替代原始数据保存。
图表
适合回答的问题
Bar Chart
各类别频数有何差异
Pareto Chart
哪些类别贡献最大
Histogram
连续变量的分布形状如何
Frequency Polygon
多组分布如何比较
Ogive
某个阈值以下的累计比例是多少
Time Series Plot
指标随时间怎样变化
Stem-and-leaf
小样本的分布和原始值是什么
Boxplot
中心、离散程度和异常值如何
直方图使用连续区间,柱子应相连;条形图表示离散类别,柱子通常分开。这是两者最直观的区别。
样本均值为:
x ˉ = 1 n ∑ i = 1 n x i . \bar{x}=\frac{1}{n}\sum_{i=1}^{n}x_i.
x ˉ = n 1 i = 1 ∑ n x i .
它使用了全部观测值,代数性质好,但容易受极端值影响。
将数据排序后,中位数是中间位置的数。它对极端值更稳健,因此收入、房价和等待时间等右偏分布常用中位数描述。
众数是出现次数最多的值,也是名义变量可以使用的中心统计量。数据可能没有众数,也可能有多个众数。
若不同观测具有权重 w i w_i w i
x ˉ w = ∑ i w i x i ∑ i w i . \bar{x}_w=\frac{\sum_i w_i x_i}{\sum_i w_i}.
x ˉ w = ∑ i w i ∑ i w i x i .
课程总评、投资组合收益率和分组数据均值都属于加权平均。
1
2
3
4
近似对称、异常值少 -> 均值 明显偏态、存在极端值 -> 中位数 类别变量 -> 众数 观测重要性不同 -> 加权均值
不要只报告一个中心值。均值相同的两个数据集,离散程度和分布形状可能完全不同。
总体方差定义为:
σ 2 = 1 N ∑ i = 1 N ( x i − μ ) 2 . \sigma^2=\frac{1}{N}\sum_{i=1}^{N}(x_i-\mu)^2.
σ 2 = N 1 i = 1 ∑ N ( x i − μ ) 2 .
如果总体均值未知,用样本均值替代它,样本方差写成:
S 2 = 1 n − 1 ∑ i = 1 n ( X i − X ˉ ) 2 . S^2=\frac{1}{n-1}\sum_{i=1}^{n}(X_i-\bar X)^2.
S 2 = n − 1 1 i = 1 ∑ n ( X i − X ˉ ) 2 .
为什么不是除以 n n n
∑ i = 1 n ( X i − X ˉ ) = 0. \sum_{i=1}^{n}(X_i-\bar X)=0.
i = 1 ∑ n ( X i − X ˉ ) = 0 .
一旦前 n − 1 n-1 n − 1 n − 1 n-1 n − 1
E [ ∑ i = 1 n ( X i − X ˉ ) 2 ] = ( n − 1 ) σ 2 . \mathbb E\left[\sum_{i=1}^{n}(X_i-\bar X)^2\right]=(n-1)\sigma^2.
E [ i = 1 ∑ n ( X i − X ˉ ) 2 ] = ( n − 1 ) σ 2 .
因此:
E [ S 2 ] = σ 2 , \mathbb E[S^2]=\sigma^2,
E [ S 2 ] = σ 2 ,
也就是说除以 n − 1 n-1 n − 1 S 2 S^2 S 2
不同单位或均值尺度下,可使用:
C V = s x ˉ × 100 % . CV=\frac{s}{\bar x}\times 100\%.
C V = x ˉ s × 1 0 0 % .
标准差为 10 对平均值 20 和平均值 100 的意义完全不同,CV 描述的是相对波动。
对任何具有有限方差的分布:
P ( ∣ X − μ ∣ < k σ ) ≥ 1 − 1 k 2 , k > 1. P(|X-\mu|<k\sigma)\ge 1-\frac{1}{k^2},\quad k>1.
P ( ∣ X − μ ∣ < k σ ) ≥ 1 − k 2 1 , k > 1 .
它不要求正态分布。例如至少 75 % 75\% 7 5 % 1 − 1 / 2 2 = 0.75 1-1/2^2=0.75 1 − 1 / 2 2 = 0 . 7 5
样本空间记作 Ω \Omega Ω Ω \Omega Ω
P ( A ∪ B ) = P ( A ) + P ( B ) − P ( A ∩ B ) . P(A\cup B)=P(A)+P(B)-P(A\cap B).
P ( A ∪ B ) = P ( A ) + P ( B ) − P ( A ∩ B ) .
若 A , B A,B A , B P ( A ∩ B ) = 0 P(A\cap B)=0 P ( A ∩ B ) = 0
P ( A ∣ B ) = P ( A ∩ B ) P ( B ) . P(A\mid B)=\frac{P(A\cap B)}{P(B)}.
P ( A ∣ B ) = P ( B ) P ( A ∩ B ) .
若:
P ( A ∩ B ) = P ( A ) P ( B ) , P(A\cap B)=P(A)P(B),
P ( A ∩ B ) = P ( A ) P ( B ) ,
则 A , B A,B A , B
P ( A ∣ B ) = P ( B ∣ A ) P ( A ) P ( B ) . P(A\mid B)=\frac{P(B\mid A)P(A)}{P(B)}.
P ( A ∣ B ) = P ( B ) P ( B ∣ A ) P ( A ) .
Bayes 公式说明:后验概率由似然和先验共同决定。即使医学检测灵敏度很高,当疾病非常罕见时,阳性结果对应的真实患病概率仍可能不高。
离散随机变量 X X X
p ( x ) = P ( X = x ) , ∑ x p ( x ) = 1. p(x)=P(X=x),\qquad \sum_x p(x)=1.
p ( x ) = P ( X = x ) , x ∑ p ( x ) = 1 .
期望与方差为:
E [ X ] = ∑ x x p ( x ) , \mathbb E[X]=\sum_x xp(x),
E [ X ] = x ∑ x p ( x ) ,
Var ( X ) = E [ X 2 ] − ( E [ X ] ) 2 . \operatorname{Var}(X)=\mathbb E[X^2]-\bigl(\mathbb E[X]\bigr)^2.
V a r ( X ) = E [ X 2 ] − ( E [ X ] ) 2 .
适用条件:固定 n n n p p p
X ∼ Bin ( n , p ) , P ( X = x ) = ( n x ) p x ( 1 − p ) n − x . X\sim\operatorname{Bin}(n,p),\qquad
P(X=x)=\binom nx p^x(1-p)^{n-x}.
X ∼ B i n ( n , p ) , P ( X = x ) = ( x n ) p x ( 1 − p ) n − x .
E [ X ] = n p , Var ( X ) = n p ( 1 − p ) . \mathbb E[X]=np,\qquad \operatorname{Var}(X)=np(1-p).
E [ X ] = n p , V a r ( X ) = n p ( 1 − p ) .
二项分布的多类别推广。每次试验可能落入 k k k
适合描述固定时间或空间区间内的稀有事件次数:
P ( X = x ) = e − λ λ x x ! , E [ X ] = Var ( X ) = λ . P(X=x)=\frac{e^{-\lambda}\lambda^x}{x!},
\qquad \mathbb E[X]=\operatorname{Var}(X)=\lambda.
P ( X = x ) = x ! e − λ λ x , E [ X ] = V a r ( X ) = λ .
典型应用包括单位时间呼叫数、事故数和网页请求数。
从有限总体中不放回抽样 时使用:
P ( X = x ) = ( K x ) ( N − K n − x ) ( N n ) . P(X=x)=\frac{\binom Kx\binom{N-K}{n-x}}{\binom Nn}.
P ( X = x ) = ( n N ) ( x K ) ( n − x N − K ) .
二项分布通常对应独立或近似独立的重复试验;超几何分布因为不放回,试验之间并不独立。
若 X ∼ N ( μ , σ 2 ) X\sim N(\mu,\sigma^2) X ∼ N ( μ , σ 2 )
f ( x ) = 1 σ 2 π exp [ − ( x − μ ) 2 2 σ 2 ] . f(x)=\frac{1}{\sigma\sqrt{2\pi}}
\exp\left[-\frac{(x-\mu)^2}{2\sigma^2}\right].
f ( x ) = σ 2 π 1 exp [ − 2 σ 2 ( x − μ ) 2 ] .
标准化:
Z = X − μ σ ∼ N ( 0 , 1 ) . Z=\frac{X-\mu}{\sigma}\sim N(0,1).
Z = σ X − μ ∼ N ( 0 , 1 ) .
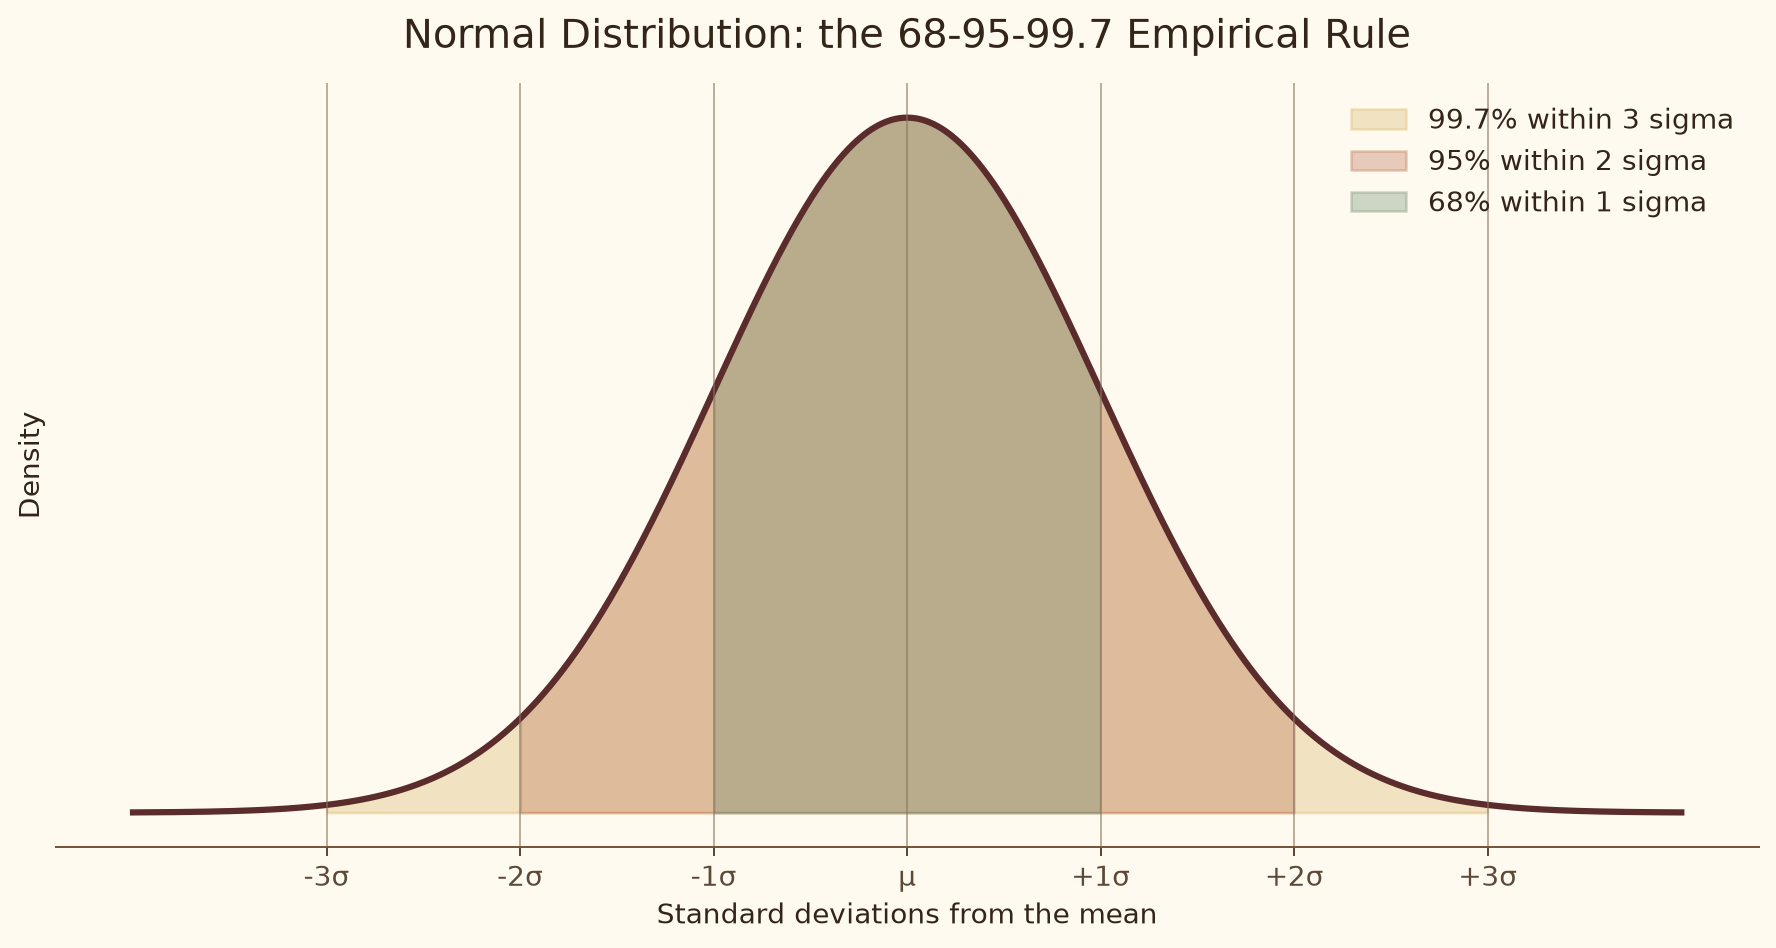
标准化把不同量纲的问题转化为同一个标准正态分布问题。经验法则是:
1
2
3
mu +/- 1 sigma : about 68% mu +/- 2 sigma : about 95% mu +/- 3 sigma : about 99.7%
正态近似二项分布时,需要连续性修正。例如:
P ( X ≤ 10 ) ≈ P ( Y < 10.5 ) , P(X\le 10)\approx P(Y<10.5),
P ( X ≤ 1 0 ) ≈ P ( Y < 1 0 . 5 ) ,
其中 Y ∼ N ( n p , n p ( 1 − p ) ) Y\sim N(np,np(1-p)) Y ∼ N ( n p , n p ( 1 − p ) )
设 X 1 , … , X n X_1,\ldots,X_n X 1 , … , X n μ \mu μ σ 2 < ∞ \sigma^2<\infty σ 2 < ∞
X ˉ = 1 n ∑ i = 1 n X i . \bar X=\frac{1}{n}\sum_{i=1}^{n}X_i.
X ˉ = n 1 i = 1 ∑ n X i .
先计算其期望和方差:
E [ X ˉ ] = μ , \mathbb E[\bar X]=\mu,
E [ X ˉ ] = μ ,
Var ( X ˉ ) = 1 n 2 ∑ i = 1 n Var ( X i ) = σ 2 n . \operatorname{Var}(\bar X)
=\frac{1}{n^2}\sum_{i=1}^{n}\operatorname{Var}(X_i)
=\frac{\sigma^2}{n}.
V a r ( X ˉ ) = n 2 1 i = 1 ∑ n V a r ( X i ) = n σ 2 .
所以样本均值的标准差,也就是标准误,为:
S E ( X ˉ ) = σ n . SE(\bar X)=\frac{\sigma}{\sqrt n}.
S E ( X ˉ ) = n σ .
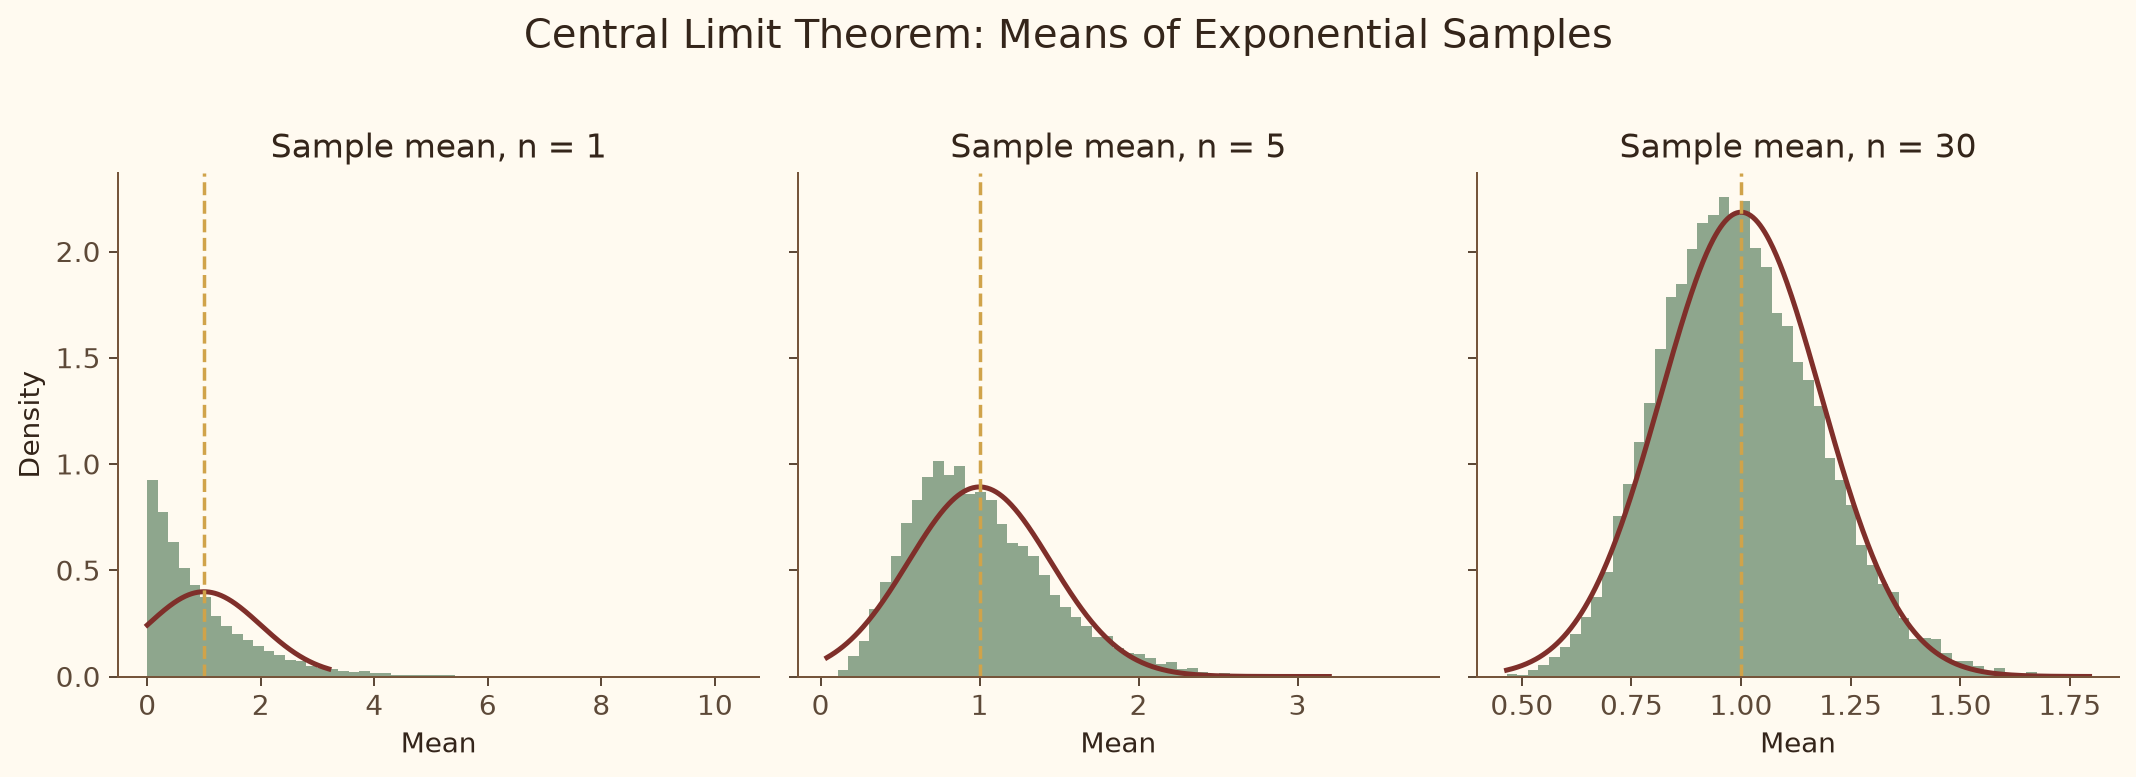
中心极限定理进一步说明,当 n n n
X ˉ − μ σ / n → d N ( 0 , 1 ) . \frac{\bar X-\mu}{\sigma/\sqrt n}
\xrightarrow{d}N(0,1).
σ / n X ˉ − μ d N ( 0 , 1 ) .
关键点是:原总体不一定正态,但样本均值的分布会逐渐接近正态。
样本量增大产生两个效果:
抽样分布更接近正态。
标准误按 1 / n 1/\sqrt n 1 / n
这也是置信区间和假设检验能够成立的核心桥梁。
估计总体参数的统计量通常从三个角度评价。
E [ θ ^ ] = θ . \mathbb E[\hat\theta]=\theta.
E [ θ ^ ] = θ .
长期重复抽样时,估计量平均不会系统性偏高或偏低。
θ ^ n → P θ . \hat\theta_n\xrightarrow{P}\theta.
θ ^ n P θ .
样本量增大时,估计量越来越接近真实参数。
在同样无偏的估计量中,方差更小的估计量更有效。
注意:无偏不等于好。单个观测 X 1 X_1 X 1 μ \mu μ σ 2 \sigma^2 σ 2 X ˉ \bar X X ˉ σ 2 / n \sigma^2/n σ 2 / n
“估计值 ± \pm ± × \times ×
设 X 1 , … , X n ∼ i i d N ( μ , σ 2 ) X_1,\ldots,X_n\overset{iid}{\sim}N(\mu,\sigma^2) X 1 , … , X n ∼ i i d N ( μ , σ 2 ) σ \sigma σ
X ˉ ∼ N ( μ , σ 2 n ) , \bar X\sim N\left(\mu,\frac{\sigma^2}{n}\right),
X ˉ ∼ N ( μ , n σ 2 ) ,
所以不含未知参数的标准化统计量
Z = X ˉ − μ σ / n ∼ N ( 0 , 1 ) Z=\frac{\bar X-\mu}{\sigma/\sqrt n}\sim N(0,1)
Z = σ / n X ˉ − μ ∼ N ( 0 , 1 )
称为枢轴量 。若 z 1 − α / 2 z_{1-\alpha/2} z 1 − α / 2 1 − α / 2 1-\alpha/2 1 − α / 2
P ( − z 1 − α / 2 ≤ Z ≤ z 1 − α / 2 ) = 1 − α . P\left(-z_{1-\alpha/2}\le Z\le z_{1-\alpha/2}\right)=1-\alpha.
P ( − z 1 − α / 2 ≤ Z ≤ z 1 − α / 2 ) = 1 − α .
把 Z Z Z μ \mu μ
P ( X ˉ − z 1 − α / 2 σ n ≤ μ ≤ X ˉ + z 1 − α / 2 σ n ) = 1 − α . P\left(
\bar X-z_{1-\alpha/2}\frac{\sigma}{\sqrt n}
\le \mu \le
\bar X+z_{1-\alpha/2}\frac{\sigma}{\sqrt n}
\right)=1-\alpha.
P ( X ˉ − z 1 − α / 2 n σ ≤ μ ≤ X ˉ + z 1 − α / 2 n σ ) = 1 − α .
因此 μ \mu μ ( 1 − α ) (1-\alpha) ( 1 − α )
X ˉ ± z 1 − α / 2 σ n . \boxed{\bar X\pm z_{1-\alpha/2}\frac{\sigma}{\sqrt n}}.
X ˉ ± z 1 − α / 2 n σ .
若总体正态但 σ \sigma σ
Z = X ˉ − μ σ / n ∼ N ( 0 , 1 ) , Z=\frac{\bar X-\mu}{\sigma/\sqrt n}\sim N(0,1),
Z = σ / n X ˉ − μ ∼ N ( 0 , 1 ) ,
U = ( n − 1 ) S 2 σ 2 ∼ χ n − 1 2 , U=\frac{(n-1)S^2}{\sigma^2}\sim\chi^2_{n-1},
U = σ 2 ( n − 1 ) S 2 ∼ χ n − 1 2 ,
并且 Z Z Z U U U
Z U / ( n − 1 ) = X ˉ − μ S / n ∼ t n − 1 . \frac{Z}{\sqrt{U/(n-1)}}
=\frac{\bar X-\mu}{S/\sqrt n}
\sim t_{n-1}.
U / ( n − 1 ) Z = S / n X ˉ − μ ∼ t n − 1 .
反解这个 t 枢轴量,得到
X ˉ ± t 1 − α / 2 , n − 1 S n . \boxed{\bar X\pm t_{1-\alpha/2,n-1}\frac{S}{\sqrt n}}.
X ˉ ± t 1 − α / 2 , n − 1 n S .
t 分布尾部更厚,正是因为用随机变量 S S S σ \sigma σ S S S
若 X ∼ Bin ( n , p ) X\sim\operatorname{Bin}(n,p) X ∼ B i n ( n , p ) p ^ = X / n \hat p=X/n p ^ = X / n
E ( p ^ ) = p , Var ( p ^ ) = p ( 1 − p ) n . E(\hat p)=p,
\qquad
\operatorname{Var}(\hat p)=\frac{p(1-p)}{n}.
E ( p ^ ) = p , V a r ( p ^ ) = n p ( 1 − p ) .
利用中心极限定理并用 p ^ \hat p p ^ p p p
p ^ ± z 1 − α / 2 p ^ ( 1 − p ^ ) n . \hat p\pm z_{1-\alpha/2}
\sqrt{\frac{\hat p(1-\hat p)}{n}}.
p ^ ± z 1 − α / 2 n p ^ ( 1 − p ^ ) .
它要求 n p ^ n\hat p n p ^ n ( 1 − p ^ ) n(1-\hat p) n ( 1 − p ^ )
已知 σ \sigma σ
E = z 1 − α / 2 σ n . E=z_{1-\alpha/2}\frac{\sigma}{\sqrt n}.
E = z 1 − α / 2 n σ .
对 n n n
n = ⌈ ( z 1 − α / 2 σ E ) 2 ⌉ . \boxed{n=\left\lceil
\left(\frac{z_{1-\alpha/2}\sigma}{E}\right)^2
\right\rceil}.
n = ⌈ ( E z 1 − α / 2 σ ) 2 ⌉ .
这揭示了三个直接关系:置信度越高,临界值越大;总体波动越大,区间越宽;误差缩小一半,样本量约需扩大四倍。
频率学派中,μ \mu μ μ \mu μ μ \mu μ
假设检验不是“证明 H 0 H_0 H 0
考虑最清楚的情形:
X 1 , … , X n ∼ i i d N ( μ , σ 2 ) , σ 已知 , X_1,\ldots,X_n\overset{iid}{\sim}N(\mu,\sigma^2),
\qquad \sigma\text{ 已知},
X 1 , … , X n ∼ i i d N ( μ , σ 2 ) , σ 已知 ,
检验
H 0 : μ = μ 0 vs H 1 : μ > μ 0 . H_0:\mu=\mu_0
\quad\text{vs}\quad
H_1:\mu>\mu_0.
H 0 : μ = μ 0 vs H 1 : μ > μ 0 .
在 H 0 H_0 H 0
Z = X ˉ − μ 0 σ / n ∼ N ( 0 , 1 ) . Z=\frac{\bar X-\mu_0}{\sigma/\sqrt n}\sim N(0,1).
Z = σ / n X ˉ − μ 0 ∼ N ( 0 , 1 ) .
若希望第一类错误概率为 α \alpha α z 1 − α z_{1-\alpha} z 1 − α
Z > z 1 − α Z>z_{1-\alpha}
Z > z 1 − α
时拒绝 H 0 H_0 H 0
P μ 0 ( Z > z 1 − α ) = α , P_{\mu_0}(Z>z_{1-\alpha})=\alpha,
P μ 0 ( Z > z 1 − α ) = α ,
所以这个拒绝域的大小恰好是 α \alpha α
X ˉ > c , c = μ 0 + z 1 − α σ n . \bar X>c,
\qquad
c=\mu_0+z_{1-\alpha}\frac{\sigma}{\sqrt n}.
X ˉ > c , c = μ 0 + z 1 − α n σ .
这个推导说明:显著性水平不是观察数据后临时决定的数字,而是构造拒绝域时预先写入检验程序的错误上限。
检验方向必须由研究问题在看数据前确定:
H 1 : μ > μ 0 : Z > z 1 − α , H 1 : μ < μ 0 : Z < − z 1 − α , H 1 : μ ≠ μ 0 : ∣ Z ∣ > z 1 − α / 2 . \begin{aligned}
H_1:\mu>\mu_0&:\quad Z>z_{1-\alpha},\\
H_1:\mu<\mu_0&:\quad Z<-z_{1-\alpha},\\
H_1:\mu\ne\mu_0&:\quad |Z|>z_{1-\alpha/2}.
\end{aligned}
H 1 : μ > μ 0 H 1 : μ < μ 0 H 1 : μ = μ 0 : Z > z 1 − α , : Z < − z 1 − α , : ∣ Z ∣ > z 1 − α / 2 .
双侧检验把 α \alpha α α \alpha α
检验结论和真实状态形成四种情况:
真实情况
不拒绝 H 0 H_0 H 0
拒绝 H 0 H_0 H 0
H 0 H_0 H 0 正确决策
第一类错误,概率 α \alpha α
H 0 H_0 H 0 第二类错误,概率 β \beta β
正确发现,概率 1 − β 1-\beta 1 − β
第一类错误是“本来没有效应却报告有效应”,第二类错误是“效应真实存在却没有检出”。但 β \beta β μ 0 \mu_0 μ 0
β ( μ ) \beta(\mu) β ( μ ) 继续使用右尾 z 检验。拒绝条件是 X ˉ > c \bar X>c X ˉ > c μ 1 > μ 0 \mu_1>\mu_0 μ 1 > μ 0
β ( μ 1 ) = P μ 1 ( 不拒绝 H 0 ) = P μ 1 ( X ˉ ≤ c ) = P μ 1 ( X ˉ − μ 1 σ / n ≤ c − μ 1 σ / n ) = Φ ( z 1 − α − ( μ 1 − μ 0 ) n σ ) . \begin{aligned}
\beta(\mu_1)
&=P_{\mu_1}(\text{不拒绝 }H_0)\\
&=P_{\mu_1}(\bar X\le c)\\
&=P_{\mu_1}\left(
\frac{\bar X-\mu_1}{\sigma/\sqrt n}
\le
\frac{c-\mu_1}{\sigma/\sqrt n}
\right)\\
&=\Phi\left(
z_{1-\alpha}-
\frac{(\mu_1-\mu_0)\sqrt n}{\sigma}
\right).
\end{aligned}
β ( μ 1 ) = P μ 1 ( 不拒绝 H 0 ) = P μ 1 ( X ˉ ≤ c ) = P μ 1 ( σ / n X ˉ − μ 1 ≤ σ / n c − μ 1 ) = Φ ( z 1 − α − σ ( μ 1 − μ 0 ) n ) .
于是功效函数为
π ( μ 1 ) = 1 − β ( μ 1 ) = 1 − Φ ( z 1 − α − ( μ 1 − μ 0 ) n σ ) . \boxed{
\pi(\mu_1)=1-\beta(\mu_1)
=1-\Phi\left(
z_{1-\alpha}-
\frac{(\mu_1-\mu_0)\sqrt n}{\sigma}
\right)
}.
π ( μ 1 ) = 1 − β ( μ 1 ) = 1 − Φ ( z 1 − α − σ ( μ 1 − μ 0 ) n ) .
令标准化效应量
d = μ 1 − μ 0 σ , d=\frac{\mu_1-\mu_0}{\sigma},
d = σ μ 1 − μ 0 ,
则功效只通过 d n d\sqrt n d n
π ( d ) = 1 − Φ ( z 1 − α − d n ) . \pi(d)=1-\Phi\left(z_{1-\alpha}-d\sqrt n\right).
π ( d ) = 1 − Φ ( z 1 − α − d n ) .
这解释了为什么“大样本很容易显著”:即使 d d d n n n d n d\sqrt n d n
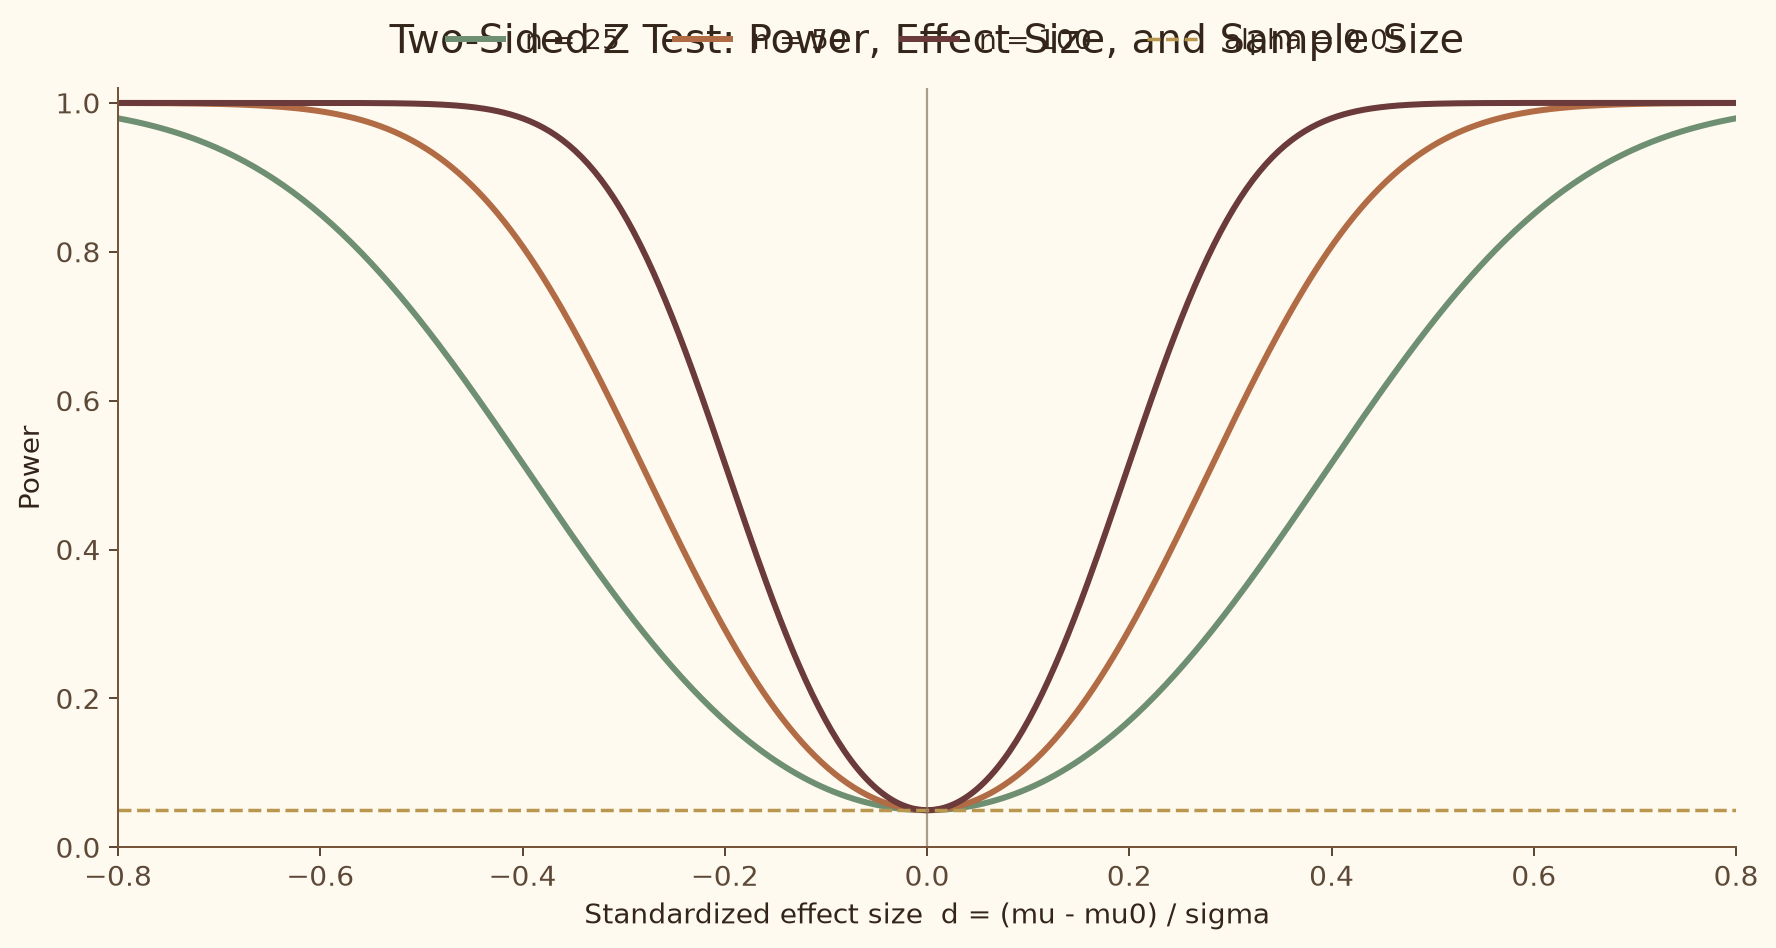
对 H 1 : μ ≠ μ 0 H_1:\mu\ne\mu_0 H 1 : μ = μ 0
λ = ( μ 1 − μ 0 ) n σ , z ∗ = z 1 − α / 2 . \lambda=\frac{(\mu_1-\mu_0)\sqrt n}{\sigma},
\qquad z^*=z_{1-\alpha/2}.
λ = σ ( μ 1 − μ 0 ) n , z ∗ = z 1 − α / 2 .
在真实均值 μ 1 \mu_1 μ 1 N ( λ , 1 ) N(\lambda,1) N ( λ , 1 )
π ( μ 1 ) = P μ 1 ( ∣ Z ∣ > z ∗ ) = P μ 1 ( Z < − z ∗ ) + P μ 1 ( Z > z ∗ ) = Φ ( − z ∗ − λ ) + 1 − Φ ( z ∗ − λ ) . \begin{aligned}
\pi(\mu_1)
&=P_{\mu_1}(|Z|>z^*)\\
&=P_{\mu_1}(Z<-z^*)+P_{\mu_1}(Z>z^*)\\
&=\Phi(-z^*-\lambda)+1-\Phi(z^*-\lambda).
\end{aligned}
π ( μ 1 ) = P μ 1 ( ∣ Z ∣ > z ∗ ) = P μ 1 ( Z < − z ∗ ) + P μ 1 ( Z > z ∗ ) = Φ ( − z ∗ − λ ) + 1 − Φ ( z ∗ − λ ) .
当 μ 1 = μ 0 \mu_1=\mu_0 μ 1 = μ 0 λ = 0 \lambda=0 λ = 0 α \alpha α ∣ μ 1 − μ 0 ∣ |\mu_1-\mu_0| ∣ μ 1 − μ 0 ∣
α \alpha α β \beta β 在样本量和真实效应固定时,降低 α \alpha α β \beta β
功效会在以下情况下提高:
样本量 n n n
真实效应 ∣ μ 1 − μ 0 ∣ |\mu_1-\mu_0| ∣ μ 1 − μ 0 ∣
数据标准差 σ \sigma σ
在方向确有理论依据时使用单侧检验;
放宽显著性水平 α \alpha α
对右尾检验,若希望在真实差异 Δ = μ 1 − μ 0 > 0 \Delta=\mu_1-\mu_0>0 Δ = μ 1 − μ 0 > 0 1 − β 1-\beta 1 − β
1 − β = 1 − Φ ( z 1 − α − Δ n σ ) 1-\beta
=1-\Phi\left(z_{1-\alpha}-\frac{\Delta\sqrt n}{\sigma}\right)
1 − β = 1 − Φ ( z 1 − α − σ Δ n )
反解得到
n = ⌈ [ ( z 1 − α + z 1 − β ) σ Δ ] 2 ⌉ . \boxed{
n=\left\lceil
\left[
\frac{(z_{1-\alpha}+z_{1-\beta})\sigma}{\Delta}
\right]^2
\right\rceil
}.
n = ⌈ [ Δ ( z 1 − α + z 1 − β ) σ ] 2 ⌉ .
例如 μ 0 = 100 \mu_0=100 μ 0 = 1 0 0 σ = 15 \sigma=15 σ = 1 5 α = 0.05 \alpha=0.05 α = 0 . 0 5 Δ = 5 \Delta=5 Δ = 5
z 0.95 = 1.645 , z 0.80 = 0.842 , z_{0.95}=1.645,
\qquad z_{0.80}=0.842,
z 0 . 9 5 = 1 . 6 4 5 , z 0 . 8 0 = 0 . 8 4 2 ,
所以
n = ⌈ [ ( 1.645 + 0.842 ) 15 5 ] 2 ⌉ = 56. n=\left\lceil
\left[\frac{(1.645+0.842)15}{5}\right]^2
\right\rceil
=56.
n = ⌈ [ 5 ( 1 . 6 4 5 + 0 . 8 4 2 ) 1 5 ] 2 ⌉ = 5 6 .
双侧检验的常用规划近似是把 z 1 − α z_{1-\alpha} z 1 − α z 1 − α / 2 z_{1-\alpha/2} z 1 − α / 2
p 值是在 H 0 H_0 H 0 z o b s z_{obs} z o b s
H 1 : μ > μ 0 : p = 1 − Φ ( z o b s ) , H 1 : μ < μ 0 : p = Φ ( z o b s ) , H 1 : μ ≠ μ 0 : p = 2 [ 1 − Φ ( ∣ z o b s ∣ ) ] . \begin{aligned}
H_1:\mu>\mu_0&:\quad p=1-\Phi(z_{obs}),\\
H_1:\mu<\mu_0&:\quad p=\Phi(z_{obs}),\\
H_1:\mu\ne\mu_0&:\quad p=2[1-\Phi(|z_{obs}|)].
\end{aligned}
H 1 : μ > μ 0 H 1 : μ < μ 0 H 1 : μ = μ 0 : p = 1 − Φ ( z o b s ) , : p = Φ ( z o b s ) , : p = 2 [ 1 − Φ ( ∣ z o b s ∣ ) ] .
以双侧检验为例,若 z o b s = 2.10 z_{obs}=2.10 z o b s = 2 . 1 0
p = 2 [ 1 − Φ ( 2.10 ) ] ≈ 0.0357. p=2[1-\Phi(2.10)]\approx0.0357.
p = 2 [ 1 − Φ ( 2 . 1 0 ) ] ≈ 0 . 0 3 5 7 .
所以在 α = 0.05 \alpha=0.05 α = 0 . 0 5 H 0 H_0 H 0 α = 0.01 \alpha=0.01 α = 0 . 0 1
当检验统计量连续且 H 0 H_0 H 0 U ( 0 , 1 ) U(0,1) U ( 0 , 1 )
P H 0 ( p ≤ α ) = α , P_{H_0}(p\le\alpha)=\alpha,
P H 0 ( p ≤ α ) = α ,
这正是“以 p 值不超过 α \alpha α
p 值并不是:
P ( H 0 ∣ data ) P(H_0\mid\text{data}) P ( H 0 ∣ data ) 结果“由随机造成”的概率;
效应量或实际重要性的大小;
下一次实验能够重复成功的概率。
p > α p>\alpha p > α H 0 H_0 H 0 H 0 H_0 H 0
若做 m m m α \alpha α
P ( 至少一次误报 ) = 1 − ( 1 − α ) m . P(\text{至少一次误报})=1-(1-\alpha)^m.
P ( 至少一次误报 ) = 1 − ( 1 − α ) m .
当 m = 20 m=20 m = 2 0 α = 0.05 \alpha=0.05 α = 0 . 0 5 α / m \alpha/m α / m
P ( ⋃ j = 1 m 第 j 次误报 ) ≤ ∑ j = 1 m α m = α . P\left(\bigcup_{j=1}^{m}\text{第 }j\text{ 次误报}\right)
\le\sum_{j=1}^{m}\frac{\alpha}{m}=\alpha.
P ( j = 1 ⋃ m 第 j 次误报 ) ≤ j = 1 ∑ m m α = α .
当 σ \sigma σ
Z = X ˉ − μ 0 σ / n . Z=\frac{\bar X-\mu_0}{\sigma/\sqrt n}.
Z = σ / n X ˉ − μ 0 .
当 σ \sigma σ
T = X ˉ − μ 0 S / n ∼ t n − 1 . T=\frac{\bar X-\mu_0}{S/\sqrt n}\sim t_{n-1}.
T = S / n X ˉ − μ 0 ∼ t n − 1 .
小样本 t 检验依赖总体近似正态;大样本时,中心极限定理使它对温和的非正态更稳健,但严重偏态和极端值仍需检查。
在 H 0 : p = p 0 H_0:p=p_0 H 0 : p = p 0
E ( p ^ ) = p 0 , Var ( p ^ ) = p 0 ( 1 − p 0 ) n . E(\hat p)=p_0,
\qquad
\operatorname{Var}(\hat p)=\frac{p_0(1-p_0)}{n}.
E ( p ^ ) = p 0 , V a r ( p ^ ) = n p 0 ( 1 − p 0 ) .
因此原假设标准误必须使用 p 0 p_0 p 0
Z = p ^ − p 0 p 0 ( 1 − p 0 ) / n . Z=\frac{\hat p-p_0}
{\sqrt{p_0(1-p_0)/n}}.
Z = p 0 ( 1 − p 0 ) / n p ^ − p 0 .
这与置信区间中常用 p ^ \hat p p ^ p = p 0 p=p_0 p = p 0
若总体正态,则
( n − 1 ) S 2 σ 2 ∼ χ n − 1 2 . \frac{(n-1)S^2}{\sigma^2}\sim\chi^2_{n-1}.
σ 2 ( n − 1 ) S 2 ∼ χ n − 1 2 .
检验 H 0 : σ 2 = σ 0 2 H_0:\sigma^2=\sigma_0^2 H 0 : σ 2 = σ 0 2
χ o b s 2 = ( n − 1 ) S 2 σ 0 2 . \chi^2_{obs}=\frac{(n-1)S^2}{\sigma_0^2}.
χ o b s 2 = σ 0 2 ( n − 1 ) S 2 .
该结论对总体正态性较敏感,因为样本方差的精确卡方分布是在正态假设下得到的。
若两组独立,且不假设方差相等,
E ( X ˉ 1 − X ˉ 2 ) = μ 1 − μ 2 , E(\bar X_1-\bar X_2)=\mu_1-\mu_2,
E ( X ˉ 1 − X ˉ 2 ) = μ 1 − μ 2 ,
Var ( X ˉ 1 − X ˉ 2 ) = σ 1 2 n 1 + σ 2 2 n 2 . \operatorname{Var}(\bar X_1-\bar X_2)
=\frac{\sigma_1^2}{n_1}+\frac{\sigma_2^2}{n_2}.
V a r ( X ˉ 1 − X ˉ 2 ) = n 1 σ 1 2 + n 2 σ 2 2 .
用样本方差替代未知总体方差,得到
T = ( X ˉ 1 − X ˉ 2 ) − Δ 0 S 1 2 / n 1 + S 2 2 / n 2 . T=\frac{(\bar X_1-\bar X_2)-\Delta_0}
{\sqrt{S_1^2/n_1+S_2^2/n_2}}.
T = S 1 2 / n 1 + S 2 2 / n 2 ( X ˉ 1 − X ˉ 2 ) − Δ 0 .
其自由度用 Welch-Satterthwaite 近似:
ν ≈ ( S 1 2 / n 1 + S 2 2 / n 2 ) 2 ( S 1 2 / n 1 ) 2 n 1 − 1 + ( S 2 2 / n 2 ) 2 n 2 − 1 . \nu\approx
\frac{(S_1^2/n_1+S_2^2/n_2)^2}
{\dfrac{(S_1^2/n_1)^2}{n_1-1}
+\dfrac{(S_2^2/n_2)^2}{n_2-1}}.
ν ≈ n 1 − 1 ( S 1 2 / n 1 ) 2 + n 2 − 1 ( S 2 2 / n 2 ) 2 ( S 1 2 / n 1 + S 2 2 / n 2 ) 2 .
Welch 检验允许方差与样本量不同,通常适合作为独立两样本均值比较的默认方法。
同一对象的前后测量不是两个独立样本。令
D i = X i − Y i , D_i=X_i-Y_i,
D i = X i − Y i ,
则问题转化为检验 H 0 : μ D = μ D , 0 H_0:\mu_D=\mu_{D,0} H 0 : μ D = μ D , 0
T = D ˉ − μ D , 0 S D / n . T=\frac{\bar D-\mu_{D,0}}{S_D/\sqrt n}.
T = S D / n D ˉ − μ D , 0 .
配对的优势可以从差值方差看出:
Var ( X − Y ) = σ X 2 + σ Y 2 − 2 ρ σ X σ Y . \operatorname{Var}(X-Y)
=\sigma_X^2+\sigma_Y^2-2\rho\sigma_X\sigma_Y.
V a r ( X − Y ) = σ X 2 + σ Y 2 − 2 ρ σ X σ Y .
当前后测量正相关,即 ρ > 0 \rho>0 ρ > 0
检验 H 0 : p 1 = p 2 = p H_0:p_1=p_2=p H 0 : p 1 = p 2 = p
p ^ = x 1 + x 2 n 1 + n 2 . \hat p=\frac{x_1+x_2}{n_1+n_2}.
p ^ = n 1 + n 2 x 1 + x 2 .
在 H 0 H_0 H 0
Var ( p ^ 1 − p ^ 2 ) = p ( 1 − p ) ( 1 n 1 + 1 n 2 ) , \operatorname{Var}(\hat p_1-\hat p_2)
=p(1-p)\left(\frac1{n_1}+\frac1{n_2}\right),
V a r ( p ^ 1 − p ^ 2 ) = p ( 1 − p ) ( n 1 1 + n 2 1 ) ,
所以
Z = p ^ 1 − p ^ 2 p ^ ( 1 − p ^ ) ( 1 / n 1 + 1 / n 2 ) . Z=\frac{\hat p_1-\hat p_2}
{\sqrt{\hat p(1-\hat p)(1/n_1+1/n_2)}}.
Z = p ^ ( 1 − p ^ ) ( 1 / n 1 + 1 / n 2 ) p ^ 1 − p ^ 2 .
若两个独立总体均为正态,且 H 0 : σ 1 2 = σ 2 2 H_0:\sigma_1^2=\sigma_2^2 H 0 : σ 1 2 = σ 2 2
F = S 1 2 S 2 2 ∼ F n 1 − 1 , n 2 − 1 . F=\frac{S_1^2}{S_2^2}\sim F_{n_1-1,n_2-1}.
F = S 2 2 S 1 2 ∼ F n 1 − 1 , n 2 − 1 .
F 检验对非正态和异常值非常敏感,实际数据中常用 Levene 或 Brown-Forsythe 检验替代。
对双侧检验
H 0 : θ = θ 0 vs H 1 : θ ≠ θ 0 , H_0:\theta=\theta_0
\quad\text{vs}\quad
H_1:\theta\ne\theta_0,
H 0 : θ = θ 0 vs H 1 : θ = θ 0 ,
所有在水平 α \alpha α θ 0 \theta_0 θ 0 ( 1 − α ) (1-\alpha) ( 1 − α )
θ 0 ∉ C I 1 − α ⟺ p < α . \theta_0\notin CI_{1-\alpha}
\quad\Longleftrightarrow\quad
p<\alpha.
θ 0 ∈ / C I 1 − α ⟺ p < α .
例如 95% 置信区间为 [ 2.1 , 5.4 ] [2.1,5.4] [ 2 . 1 , 5 . 4 ] H 0 : θ = 0 H_0:\theta=0 H 0 : θ = 0 H 0 : θ = 3 H_0:\theta=3 H 0 : θ = 3
r = ∑ i ( x i − x ˉ ) ( y i − y ˉ ) ∑ i ( x i − x ˉ ) 2 ∑ i ( y i − y ˉ ) 2 . r=\frac{\sum_i(x_i-\bar x)(y_i-\bar y)}
{\sqrt{\sum_i(x_i-\bar x)^2\sum_i(y_i-\bar y)^2}}.
r = ∑ i ( x i − x ˉ ) 2 ∑ i ( y i − y ˉ ) 2 ∑ i ( x i − x ˉ ) ( y i − y ˉ ) .
它满足 − 1 ≤ r ≤ 1 -1\le r\le1 − 1 ≤ r ≤ 1 线性 关系方向和强度。
注意:
r = 0 r=0 r = 0 极端值可能显著改变 r r r
相关系数没有单位;
相关不等于因果。
简单线性回归模型:
Y i = β 0 + β 1 X i + ε i . Y_i=\beta_0+\beta_1X_i+\varepsilon_i.
Y i = β 0 + β 1 X i + ε i .
最小二乘法选择 b 0 , b 1 b_0,b_1 b 0 , b 1
S S E = ∑ i = 1 n ( y i − b 0 − b 1 x i ) 2 . SSE=\sum_{i=1}^{n}(y_i-b_0-b_1x_i)^2.
S S E = i = 1 ∑ n ( y i − b 0 − b 1 x i ) 2 .
对 b 0 , b 1 b_0,b_1 b 0 , b 1
b 1 = ∑ i ( x i − x ˉ ) ( y i − y ˉ ) ∑ i ( x i − x ˉ ) 2 , b_1=\frac{\sum_i(x_i-\bar x)(y_i-\bar y)}
{\sum_i(x_i-\bar x)^2},
b 1 = ∑ i ( x i − x ˉ ) 2 ∑ i ( x i − x ˉ ) ( y i − y ˉ ) ,
b 0 = y ˉ − b 1 x ˉ . b_0=\bar y-b_1\bar x.
b 0 = y ˉ − b 1 x ˉ .
斜率 b 1 b_1 b 1 X X X Y Y Y
R 2 = 1 − S S E S S T . R^2=1-\frac{SSE}{SST}.
R 2 = 1 − S S T S S E .
在简单线性回归中 R 2 = r 2 R^2=r^2 R 2 = r 2 R 2 R^2 R 2
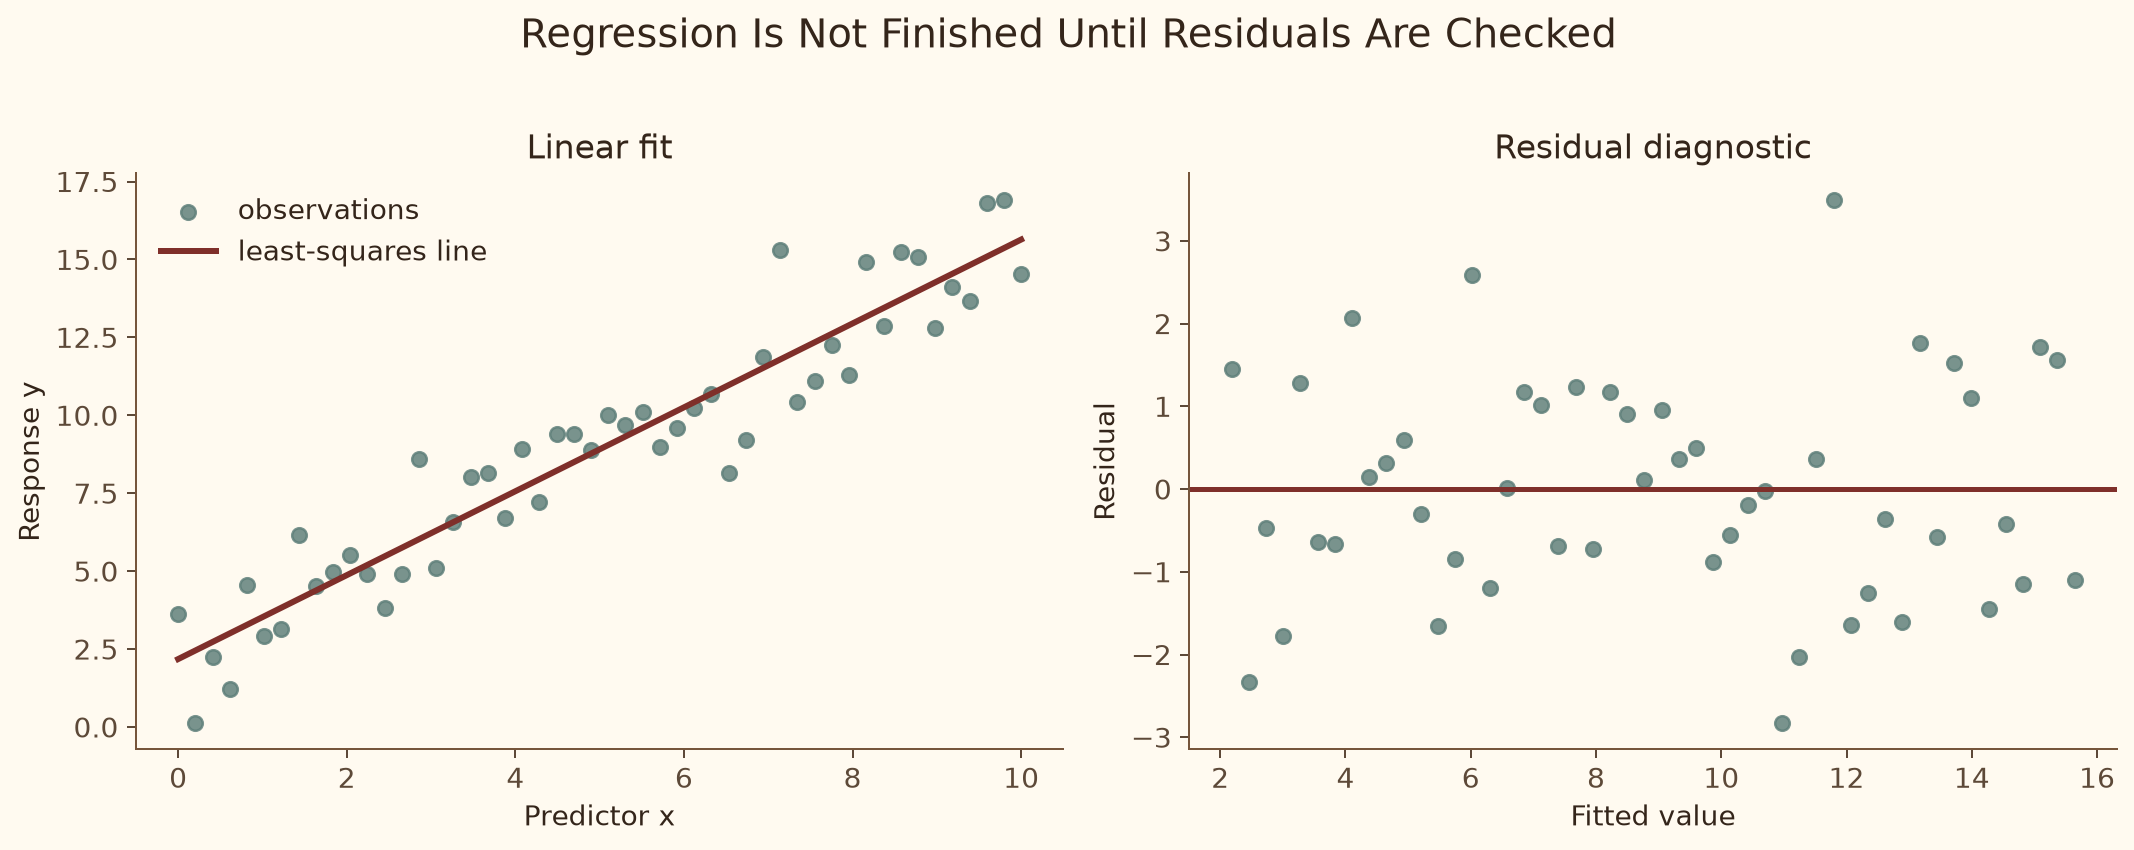
线性回归通常检查:
线性关系;
误差独立;
同方差性;
残差近似正态;
不存在支配结果的异常点。
残差图若呈漏斗形,提示异方差;若呈弯曲结构,提示线性模型遗漏了非线性关系。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
import numpy as npimport pandas as pdfrom scipy import statsrng = np.random.default_rng(42 ) group_a = rng.normal(loc=72 , scale=8 , size=40 ) group_b = rng.normal(loc=77 , scale=9 , size=45 ) summary = pd.DataFrame({"A" : group_a, "B" : pd.Series(group_b)}) print (summary.describe())n = len (group_a) mean = group_a.mean() se = stats.sem(group_a) ci = stats.t.interval(0.95 , df=n - 1 , loc=mean, scale=se) print ("mean:" , mean, "95% CI:" , ci)result = stats.ttest_ind(group_a, group_b, equal_var=False ) print ("t statistic:" , result.statistic)print ("p value:" , result.pvalue)pooled_sd = np.sqrt( ((len (group_a) - 1 ) * group_a.var(ddof=1 ) + (len (group_b) - 1 ) * group_b.var(ddof=1 )) / (len (group_a) + len (group_b) - 2 ) ) cohens_d = (group_b.mean() - group_a.mean()) / pooled_sd print ("Cohen's d:" , cohens_d)alpha = 0.05 mu0 = 100 mu1 = 105 sigma = 15 n = 56 z_critical = stats.norm.ppf(1 - alpha) noncentrality = (mu1 - mu0) * np.sqrt(n) / sigma power = 1 - stats.norm.cdf(z_critical - noncentrality) print ("theoretical power:" , power)target_power = 0.80 z_power = stats.norm.ppf(target_power) required_n = np.ceil( ((z_critical + z_power) * sigma / (mu1 - mu0)) ** 2 ).astype(int ) print ("required sample size:" , required_n)
不要只输出 p-value。一个更完整的分析至少应报告:
1 样本量 + 描述统计 + 效应估计 + 置信区间 + p-value + 方法假设
问题
数据结构
常用方法
一个总体均值是否等于给定值
连续变量,σ \sigma σ
One-sample t-test
两个独立总体均值是否不同
两组独立连续数据
Welch t-test
同一对象前后是否变化
配对连续数据
Paired t-test
一个总体比例是否等于给定值
二分类结果
One-proportion z-test / exact test
两组比例是否不同
两组二分类结果
Two-proportion z-test / chi-square
一个总体方差是否等于给定值
正态连续数据
Chi-square variance test
两个总体方差是否相同
两组正态连续数据
F-test;稳健替代为 Levene
两个连续变量是否线性相关
成对连续数据
Pearson correlation
用一个连续变量预测另一个
响应与预测变量
Simple linear regression
如果正态性或异常值问题严重,可考虑非参数方法,例如 Mann-Whitney U、Wilcoxon signed-rank 和 Spearman correlation。
看到 p-value 很小就认为效应一定很大。
p-value 大于 0.05 就宣布“两个总体完全相同”。
忽略独立、正态、同方差等方法假设。
对偏态且有极端值的数据只报告均值。
把相关关系写成因果关系。
用训练数据上的高 R 2 R^2 R 2
在看完数据后反复修改假设,却仍按一次检验解释 p-value。
同时做大量检验却不控制多重比较错误。
只报告显著性,不报告置信区间和效应量。
把“95% 置信”解释成参数有 95% 概率落在已算出的区间里。
这 10 讲不是彼此孤立的章节。它们可以压缩成一条推理链:
1
2
3
4
5
6
7
8
9
10
抽样决定数据是否有代表性 -> 描述统计帮助理解样本 -> 概率刻画随机性 -> 分布描述统计量的随机规律 -> CLT 给出样本均值的近似分布 -> 标准误衡量抽样波动 -> 置信区间给出参数的合理范围 -> 假设检验量化反对基准假设的证据 -> 两样本方法比较群体 -> 回归把关系、解释和预测统一起来
真正掌握统计学,不是记住更多公式,而是看到一个问题时能够回答:
总体和样本分别是什么?
变量属于什么类型?
数据怎样产生,是否存在偏差?
我需要描述、估计、比较还是预测?
方法依赖哪些假设?
结论中的不确定性有多大?
当这六个问题能够答清楚,公式就不再是一堆孤立符号,而是同一套推断逻辑的不同工具。