从规则检索到 GraphRAG:贵州统计指标系统的架构、混合召回与工程优化
本文是 Guizhou-GraphRAG 的技术复盘。项目面向贵州统计指标检索:输入一句口语问题,系统需要从 2000 多条结构相似的指标中找出正确实体,并返回定义、类别、匹配证据和图谱关系。
这里最难的并不是接入 LLM,而是同时处理三类冲突:召回率与精确率的冲突、语义相似与统计口径的冲突、模型能力与结果可控性的冲突。 项目最终采用“指标知识图谱 + 多路召回 + 规则排序 + 可选模型精排”的架构,并通过单字保护、候选门控、动态权重、向量缓存和服务降级等工程优化建立可用闭环。
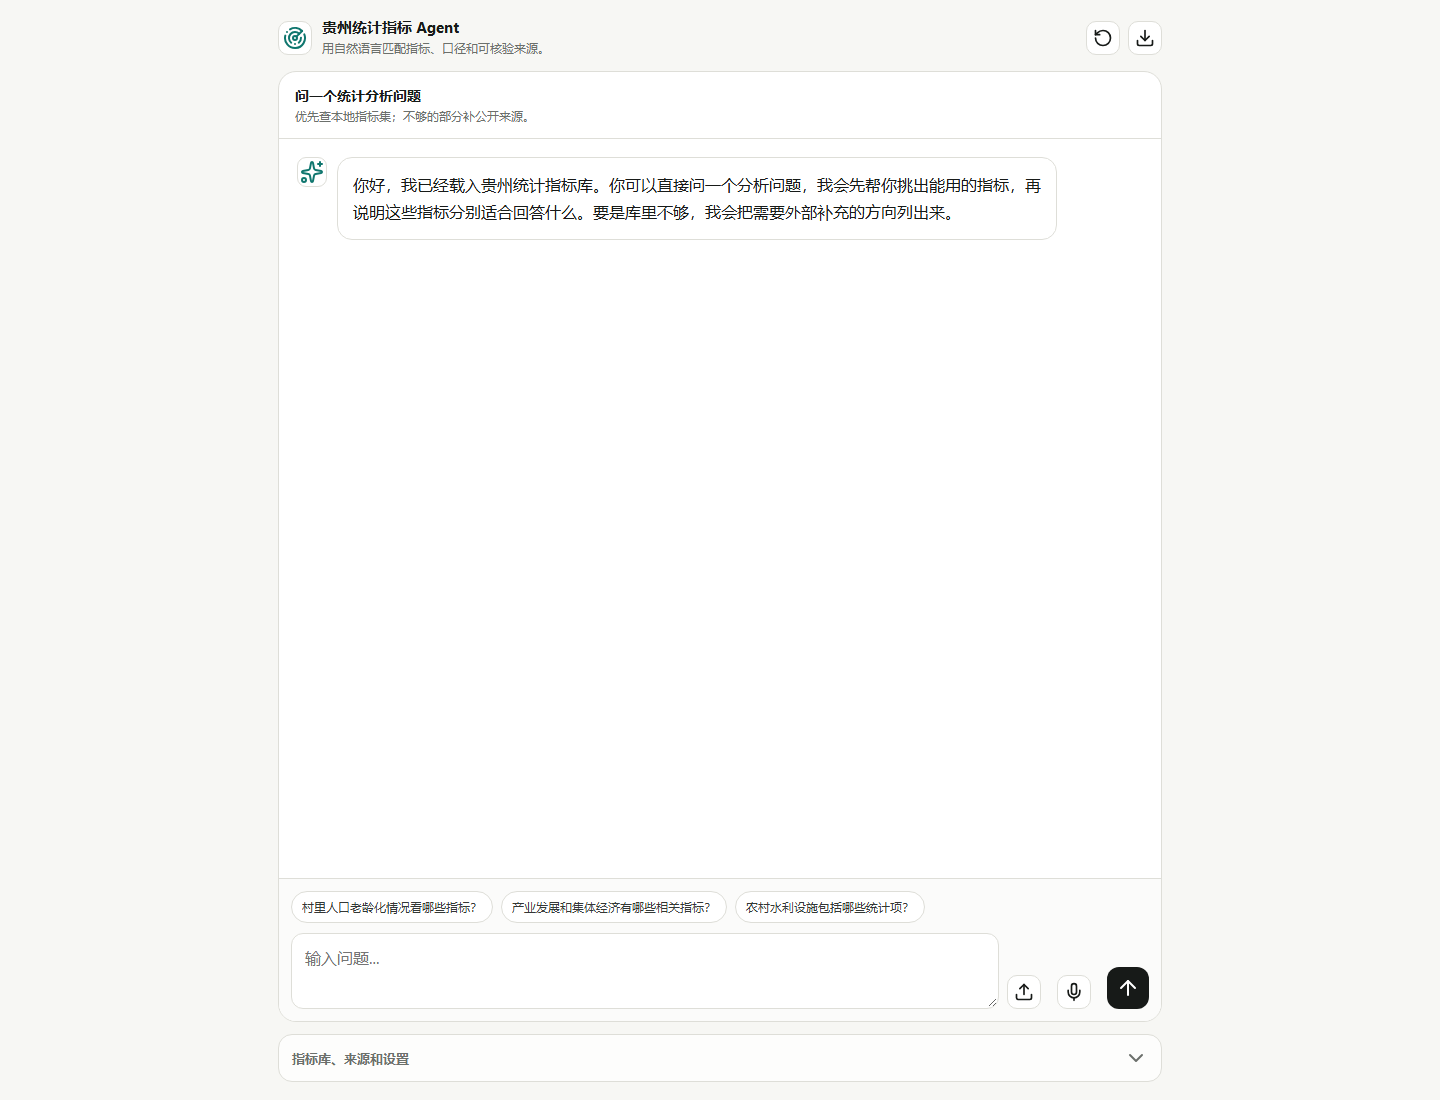
1. 任务定义:这不是一个普通聊天机器人
输入:
1 | 村里没人照顾的老人有多少? |
期望输出不是模型自由生成的“老龄化分析”,而是指标库中真实存在的实体,例如:
1 | { |
因此,这个项目本质上更接近一个 Entity Retrieval / Semantic Search 系统,而不是生成式问答:
1 | Natural Language Query -> Constrained Retrieval -> Ranked Metric Entities |
它必须满足以下约束:
- 返回的指标一定存在于授权指标库,不能由 LLM 创造。
- “数量、面积、情况、是否”等高频属性不能单独构成相关性。
- “马铃薯”和“土豆”需要互相召回,但用户原词仍要优先。
- “马”不能因为字符串包含关系召回“马铃薯”。
- 指标库或模型服务不可用时,系统要有明确的降级路径。
2. 技术栈与模块划分
后端与检索
| 技术 | 用途 |
|---|---|
| Python 3.11 | 主开发语言 |
| Flask | /api/search、/api/voice-query 与健康检查 |
NetworkX MultiDiGraph |
指标实体、别名、定义、类别和父子关系图 |
| NumPy | Embedding 矩阵归一化与余弦相似度计算 |
| Pandas | 评测集读取、明细汇总和指标计算 |
| RapidFuzz | 中文指标名称与口语表达的模糊匹配 |
| pypinyin | 同音字、ASR 错音与拼音候选生成 |
| Requests | 调用 LLM、Embedding、Reranker 和远程 ASR 服务 |
模型与语音
| 技术 | 用途 |
|---|---|
| OpenAI-compatible LLM / Qwen | 查询规划、候选重排和匹配解释 |
| Remote Embedding API | Bi-Encoder 语义召回 |
sentence-transformers CrossEncoder |
可选二阶段精排,默认关闭 |
| FunASR | 本地中文 ASR,可选依赖 |
| Windows SAPI / Browser Speech API | 语音识别降级方案 |
前端与部署
| 技术 | 用途 |
|---|---|
| Vanilla JavaScript + CSS | 对话界面、指标概览、语音上传和结果渲染 |
| Lucide Icons | 交互图标 |
| GitHub Pages | 公开静态页面 |
| 环境变量 | 运行时注入指标路径、模型地址和密钥 |
仓库中的核心文件:
1 | Guizhou-GraphRAG/ |
3. 端到端请求链路
一次查询会经历以下阶段:
1 | 用户文本 / 语音 |
与常见的“文档切块 -> 向量库 -> LLM 回答”不同,这里检索的是结构化指标实体。向量相似度只是证据之一,最终排序还必须考虑对象、属性、条件、图关系与统计口径。
4. 数据建模:先把指标拆成语义骨架
原始指标文本会被解析成结构化记录:
1 | { |
解析过程包括类别识别、“其中”子指标处理、名称与定义拆分、填报来源提取,以及 object / property / condition 抽取。随后系统基于规范名和语义骨架生成受控别名。
这一步直接影响检索精度。例如“生活垃圾数量”和“生活垃圾是否进行分类”对象相同,但属性不同。只计算 embedding 或字符串重合,很容易把它们排得过近;显式建模对象和属性后,排序器才能识别统计口径差异。
5. 图谱设计:NetworkX MultiDiGraph
项目使用 nx.MultiDiGraph(),因为同一对节点之间可能存在多种关系。节点类型包括:
1 | Category / Metric / Alias / Definition / Source |
主要边类型:
1 | Category -HAS_METRIC-> Metric |
图谱不是越密越好。项目只允许沿有业务意义的关系扩展候选,并给不同边设置不同证据强度:
1 | add_candidate(parent, 0.85, "父指标扩展") |
父子关系比“同类别”更强,因此权重更高。这个设计避免同一大类中的大量指标被无差别扩展出来。
6. 查询规范化:只能纠正到指标库中的实体
通用纠错模型可能把地方口语改成语言上更常见、业务上却不存在的词。项目因此使用 metric-library constrained normalization:任何自动改写结果都必须对应一个已存在的指标名或别名。
候选生成组合了五类信号:
- Exact alias:
洋芋 -> 马铃薯。 - Pinyin exact:处理同音字。
- Shape confusion:
马玲薯 -> 马铃薯。 - Missing character / pinyin prefix:处理 ASR 漏字。
- RapidFuzz:处理轻微编辑距离。
API 不会直接采用第一条模糊候选,而是经过安全门槛:
1 | if confidence == "low" or score < 0.82: |
设计原则是“不确定时保留原问题,优于自信地改成错误指标”。仓库中的测试覆盖了 洋芋 -> 马铃薯、马玲薯 -> 马铃薯、单字不扩展和低置信别名不改写。
7. Local、Global 与跨类别路由
系统首先判断问题粒度:
| 类型 | 示例 | 检索对象 |
|---|---|---|
local |
村里没人照顾的老人有多少 | Metric |
global |
农田水利有哪些指标 | Category Community |
cross_category |
产业发展和经济发展有哪些指标 | Multiple Communities |
早期版本把所有问题都送进同一套指标排序,导致“有哪些指标”这类概览问题得到几个零散实体。增加路由后,具体问题优化 Top-1,概览问题返回类别摘要,多主题问题则合并多个社区。路由还返回置信度,低置信问题不会被过早硬分流。
8. 混合召回实现
8.1 Exact + Fuzzy + Vector
hybrid_search_metrics 合并三路结果:
1 | for item in exact_core_search_metrics(G, query, top_k=20): |
Exact 负责精度,Fuzzy 负责字面变化,Vector 负责语义改写。候选使用指标名去重,同一路得分取最大值。
8.2 Embedding 索引与缓存
指标卡片由名称、类别、别名、对象、属性、条件和定义拼接而成。向量生成使用 batch 请求,之后做 L2 normalization:
1 | matrix = np.asarray(matrix, dtype=np.float32) |
在线查询通过一次矩阵乘法计算余弦相似度:
1 | query_vector = normalize_matrix(query_vector.reshape(1, -1))[0] |
为了避免每次启动重新编码全部指标,索引写入 metric_embeddings.npz,同时保存 metric_embedding_texts.json。只有当当前指标文本与缓存文本完全一致时才复用向量,避免数据变化后使用过期索引。
9. Candidate Relevance Gate:先挡噪声,再打分
仅靠加权评分无法可靠处理所有短词。项目在排序前增加候选门控:
1 | if query_norm == metric_norm: |
候选至少要满足完全相等、长度不少于 2 的短语/别名证据、共享中文字 bigram,或者向量相似度达到 0.78。这项优化解决了“只共享一个汉字也进入候选池”的问题,过滤放在图扩展和排序之前还能减少后续计算。
10. 排序函数与动态权重
开启 Embedding 时,局部 GraphRAG 排序为:
1 | score = |
关闭 Embedding 时,权重重新分配给可观测信号:
1 | score = |
semantic_score 是对象、属性、条件组成的语义骨架匹配;plan_score 来自可选 LLM 查询规划;penalty_score 用于压低“基本情况、数量、面积”等宽泛指标。
高覆盖候选会额外加分,但只有指标长度相对查询足够长时才生效:
1 | if coverage >= 0.92 and metric_length >= max(2, query_length * 0.45): |
长度约束是为了防止短通用指标仅凭子串重合超过更具体的指标。
11. 最棘手的优化:单字实体保护
查询“马”是典型 failure case:
1 | 错误:马 -> 马铃薯、马铃薯种植面积、马铃薯产量 |
项目没有继续微调模糊权重,而是为长度为 1 的实体建立独立路径:
1 | if len(short_query) == 1: |
单字必须先命中同名实体。图谱扩展只能在该实体所属类别内发生,并经过“总量、产量、存栏、出栏、养殖”等领域聚合词过滤。
LLM 重排以后还会把精确实体插回首位,避免模型因为语义丰富度偏爱更长候选。这说明明确的业务不变量应该写成保护规则,而不是期待模型每次推理时自己悟出来。
12. LLM 与 Cross-Encoder 的边界
LLM 查询规划输出结构化 JSON:
1 | { |
这些字段只提供召回线索,最终指标必须来自候选集合。
reranker_server.py 使用 sentence_transformers.CrossEncoder,默认模型可配置为 BAAI/bge-reranker-v2-m3。它作为独立 Flask 服务部署:
1 | 混合召回 Top-30 -> POST /v1/rerank -> 规则分与 CE 分数融合 |
模型使用 @lru_cache(maxsize=1) 懒加载,避免每次请求重新载入权重。Cross-Encoder 当前默认关闭,因为更复杂的模型不代表线上指标一定更好;只有同口径测试中 Top-1 提升且关键样例不退化,才适合成为默认排序器。
13. 后端工程优化
13.1 图谱单例与并发加载锁
图谱构建和索引准备成本较高,API 使用进程内单例:
1 | _load_lock = threading.Lock() |
双重检查避免并发首请求重复构图,后续请求直接复用内存图。
13.2 可选服务与自动降级
Embedding 和 Cross-Encoder 通过环境变量显式开启,默认关闭。向量服务调用失败时,系统继续使用 exact、fuzzy 和 graph 结果;前端请求后端失败时,也会退回本地 matcher。设计目标是“增强能力可以失败,基础检索不能一起消失”。
13.3 参数与密钥隔离
运行时通过环境变量配置指标路径、LLM、Embedding、Reranker 和 ASR。生产前端不直接持有密钥,授权指标、Embedding 缓存和图谱快照也不提交到公开仓库。
14. 语音查询的三级 fallback
语音链路复用文本检索:
1 | Audio -> ASR -> normalized_query -> 原 GraphRAG pipeline |
ASR adapter 按优先级选择:
ASR_URL指向的远程服务。- 本地 FunASR:
paraformer-zh + fsmn-vad + ct-punc。 - Windows Chinese SAPI。
通过 ASR_HOTWORDS 注入“马铃薯、洋芋、包谷、红苕”等领域词。即使 ASR 仍产生“马玲薯”,后续 normalizer 还会进行指标库约束纠错,形成“领域热词 + 检索词纠错”的两层容错。
15. 从初版到当前版本,做了哪些优化
根据仓库提交历史,系统经历了以下演进:
| 阶段 | 问题 | 优化 |
|---|---|---|
| 前端离线 matcher | 仅靠名称和关键词 | 加入对象、属性、路由与覆盖度 |
| 后端化 | 浏览器难以保护数据和凭据 | 增加 Flask API,前端只消费受控结果 |
| Qwen 接入 | 规则难理解复杂口语 | LLM 只做查询规划和候选内重排 |
| 图谱扩展 | 直接召回漏掉父子指标 | 增加父子、同对象、同属性和类别扩展 |
| 短词噪声 | “马”误命中“马铃薯” | 单字独立路径、bigram gate、精确命中置顶 |
| 路由混乱 | 概览问题返回零散指标 | 增加 local/global/cross-category 路由和置信度 |
| 拼写与方言 | 口语、错音和形近字难匹配 | 指标库约束纠错、pinyin、RapidFuzz、农村口语词典 |
| 向量成本 | 启动时重复生成向量 | batch encoding、L2 归一化、.npz 缓存与一致性校验 |
| 服务稳定性 | 模型故障会阻塞检索 | 可选服务默认关闭,异常时降级 |
| 语音输入 | 录音格式和识别环境不统一 | Remote ASR、FunASR、Browser/SAPI 多级 fallback |
| 回归风险 | 修一个 case 容易破坏另一个 | 100 条 API 评测 + 关键特殊样例 |
16. 评测方法与当前结果
评测脚本通过真实 /api/search 发送问题,让查询规范化、路由、图谱、LLM 和序列化全部进入测试范围。
1 | Top1 = 正确指标排第一的问题比例 |
当前 100 条测试基线:
| Metric | Result |
|---|---|
| Top-1 Accuracy | 89.58% |
| Recall@5 | 100% |
| MRR@5 | 94.44% |
| Category Recall | 96.15% |
测试还显式记录 short_exact_hit 和 potato_noise_free,分别检查“马”是否精确命中,以及搜索“马铃薯”时是否错误混入“马”。
Recall@5 已达到 100%,说明当前主要瓶颈不是“有没有召回”,而是前五名内部顺序。下一阶段应优先优化 Top-1 和 MRR,而不是继续扩大候选池。
仓库没有保存每个优化提交对应的完整消融结果,因此这里只报告最终同口径基线,不虚构每项规则带来的百分比提升。后续应建立版本化 evaluation artifact,才能回答“哪项优化贡献最大”。
17. 本地运行
1 | py -3.11 -m venv .venv |
调用接口:
1 | $body = @{ |
18. 仍然存在的技术债务
indicator_graphrag_core.py体积较大,解析、图构建、召回、排序与评测应拆成独立 package。- 规则权重仍依赖人工调参,可引入标注数据训练 Learning-to-Rank。
- NetworkX 适合当前内存图;数据和并发增长后应评估持久化图数据库或关系数据库。
- Embedding 当前使用全量 NumPy 点积;指标达到百万级时应替换为 FAISS、Milvus 或 pgvector ANN。
- 缺少版本化消融实验,需要保存每次提交的评测配置、结果和失败样例。
- CORS 默认值是
*,生产环境应配置明确来源并加入认证、限流与审计日志。 - 后端通过动态加载核心脚本复用 notebook 风格代码,后续应改成正常模块导入和配置注入。
19. 总结
Guizhou-GraphRAG 建立了一条受约束、可解释、可评测的检索链路:
1 | 口语 / 方言 / 语音 |
这个项目让我更明确地认识到:LLM 应用的可靠性通常不来自某一个更大的模型,而来自任务约束、检索设计、降级策略、回归测试和持续误差分析共同形成的工程系统。
从规则检索到 GraphRAG:贵州统计指标系统的架构、混合召回与工程优化
https://richardf123.github.io/2026/09/27/guizhou-graphrag-indicator-retrieval-system/